
Fem dages autonom lokal AI-udvikling: fra 77 % til 99 %
Fem dage med et eksperimentelt selvforbedrende udviklingsmiljø omkring en frossen lokal model: kvalitet, hastighed, omkostning og åbne spørgsmål.
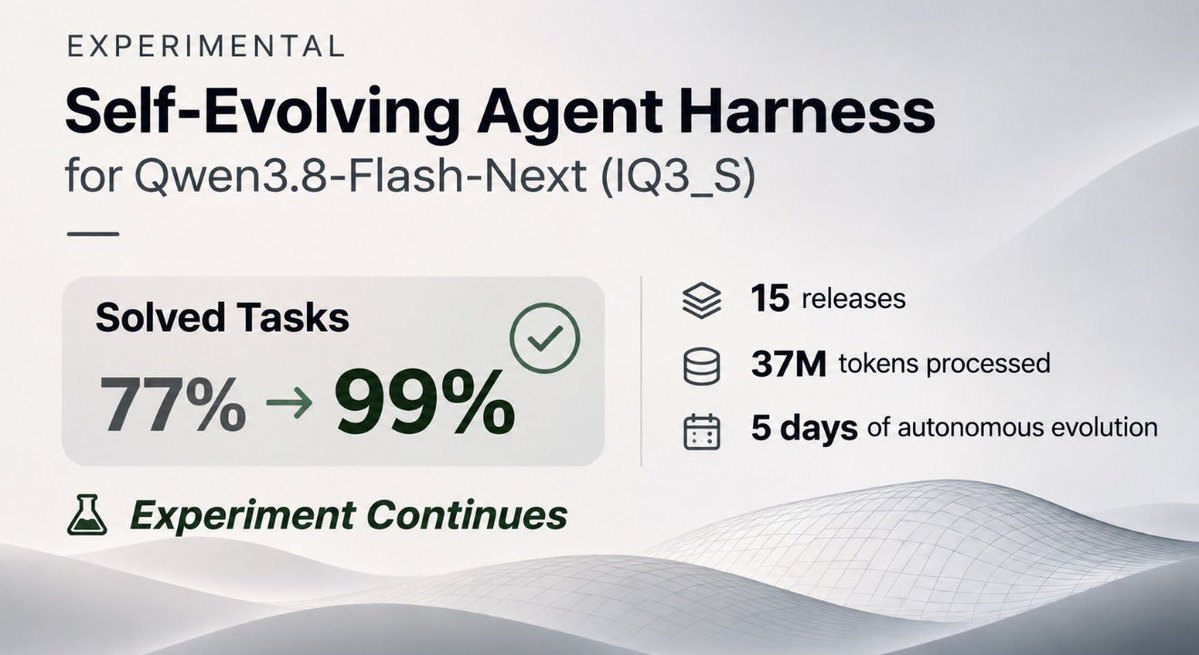
Mellem 31. oktober og 5. november 2026 hævede et eksperimentelt udviklingsmiljø for Qwen3.8-Flash-Next IQ3_S andelen af perfekt løste opgaver fra 77 % til 99 % på et fast sæt af 178 opgaver (fakturaer, tabeller, diagnostik, kode og filtrering). Modelvægtene blev ikke gen-trænet.
Inferens flyttede fra Strata til Basalt. Decode steg fra ca. 80 til 130–220 tok/s; prefill omtrent fordobledes; hele benchmark-kørslen faldt fra 87 minutter til 6,9. Udviklingsmiljøet gennemgik 15 releases med kontraktkontroller.
På maskinerne brugt til benchmark-kørsler var der omkring 34.000 modelkald og omkring 37 millioner tokens. Arbejdet kørte autonomt under faste regler med menneskelige gennemgange ved beslutningspunkter.
Anslået omkostning for samme tokenvolumen via kommercielle API'er (antar 33M input og 4M output, typiske offentlige priser): i størrelsesordenen tusinder af dollars. Den lokale kørsel brugte hardware allerede tilgængelig i laboratoriet.
Mod en baseline af den rå model med samme beregningsbudget (blind best-of-2) scorede udviklingsmiljøet +13,5 procentpoint. Holdout-kørsler kører for at kontrollere robusthed på ukendte opgaver. Releases, metode og benchmarks er på GitHub.