
Fünf Tage autonome lokale KI-Entwicklung: von 77 % auf 99 %
Fünf Tage eines experimentellen selbstverbessernden Entwicklungsumgebung um ein eingefrorenes lokales Modell: Qualität, Tempo, Kosten und offene Punkte.
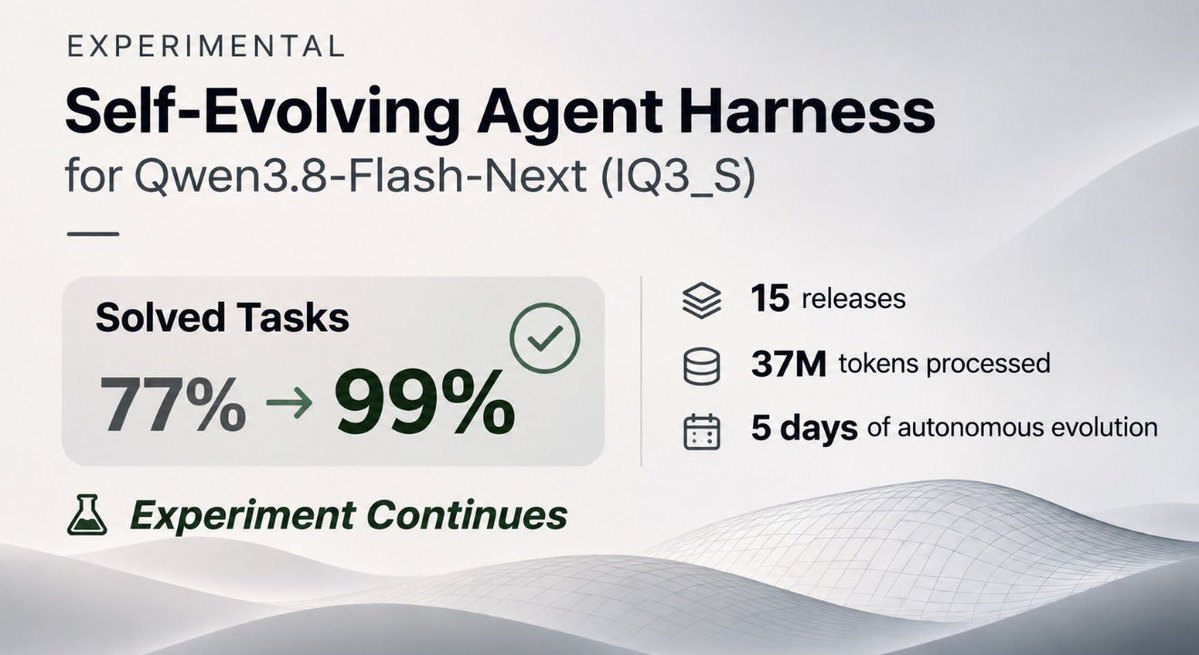
Zwischen dem 31. Oktober und dem 5. November 2026 hob eine experimentelle Entwicklungsumgebung für Qwen3.8-Flash-Next IQ3_S den Anteil perfekt gelöster Aufgaben von 77 % auf 99 % auf einem festen Satz von 178 Aufgaben (Rechnungen, Tabellen, Diagnose, Code und Filter). Die Modellgewichte wurden nicht fine-getuned.
Die Inferenz wechselte von Strata zu Basalt. Decode stieg von etwa 80 auf 130–220 tok/s; Prefill etwa verdoppelt; ein voller Benchmark-Lauf fiel von 87 Minuten auf 6,9. Die Entwicklungsumgebung hatte 15 Releases mit Vertragskontrollen.
Auf den Benchmark-Maschinen gab es etwa 34.000 Modellaufrufe und etwa 37 Millionen verarbeitete Tokens (etwa 4 Millionen nützliche Antwort-Tokens). Kalenderzeit: 120 Stunden; ein großer Teil der Kapazität blieb wegen Hardwarewechseln, Neustarts und Warten auf menschliche Entscheidungen ungenutzt.
Geschätzte API-Kosten für dasselbe Tokenvolumen (33M Eingabe und 4M Ausgabe, Standardtarife, ohne Cache): Qwen Flash etwa 3,25 $; DeepSeek Flash 7–15 $; Gemini 2.5 Flash etwa 20 $; GPT-5.4 Mini etwa 43 $; Grok 4.3 etwa 51 $; Claude Sonnet 5.5 etwa 106 $; GPT-5.4 etwa 143 $. Lokaler Strom über fünf Tage etwa 7–10 € bei 0,25 €/kWh inklusive Idle. Das ist eine Skalenprüfung, kein Anspruch, lokale KI sei immer billiger oder Modelle seien gleich.
Gegen eine rohmodellige Baseline mit gleichem Rechenbudget (blindes Best-of-2) lag die Entwicklungsumgebung +13,5 Prozentpunkte höher. Holdout-Läufe prüfen, ob Gewinne auf ungesehenen Aufgaben halten. Releases, Methode und Benchmarks liegen auf GitHub.