
News
Autonome Strata-Schleife: RTX 3060 gegen Mac Studio M3, erste Ergebnisse
Ein Modell (Qwen3.8-Flash-Next IQ3_S), dieselben Dateien und dieselbe Strata-Version auf zwei sehr unterschiedlichen Konfigurationen. Daten der letzten 12 Stunden.
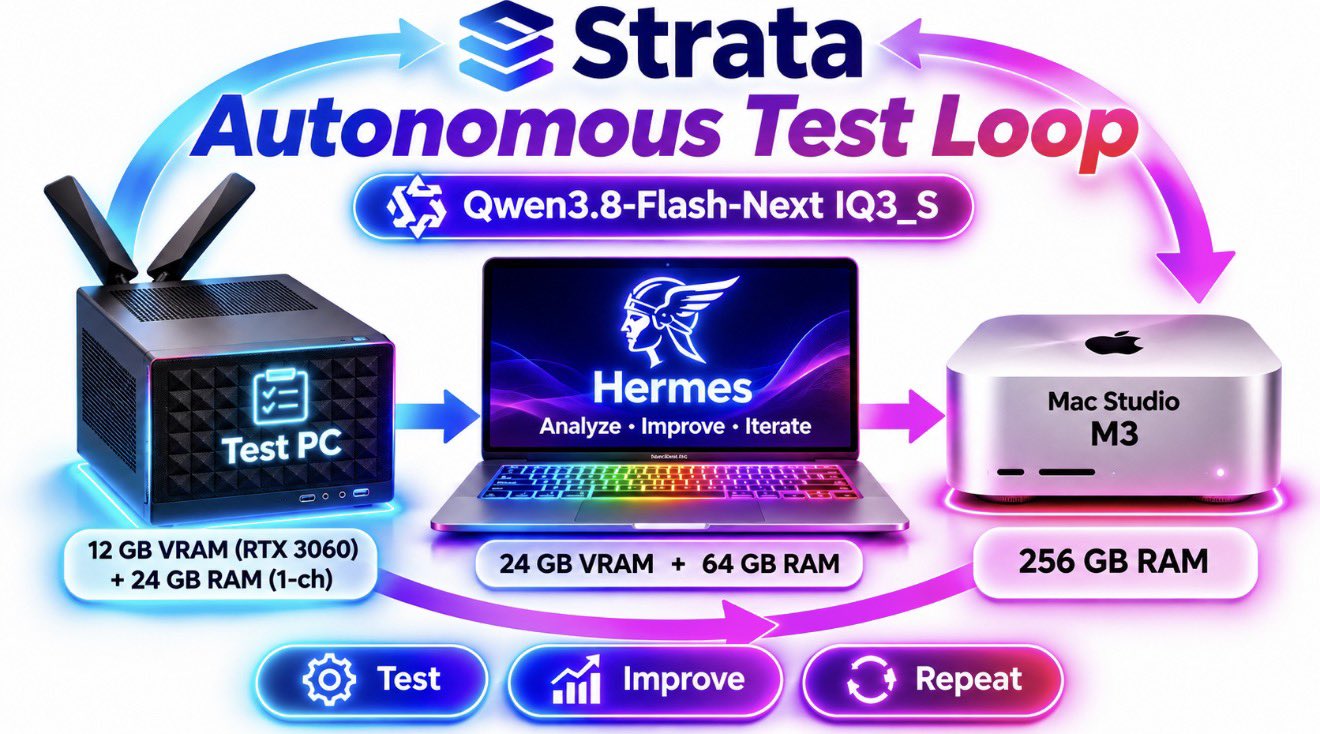
Konfiguration
- Experiment-PC: RTX 3060 mit 12 GB VRAM und 24 GB Single-Channel-RAM; extrem knapper Speicher und aggressive Laufzeiteinstellungen. Läuft 24/7.
- Hermes (Computer P2005): 24 GB VRAM und 64 GB RAM. Analysiert Ergebnisse, überprüft die Arbeit, nimmt Verbesserungen vor.
- Mac Studio M3: 256 GB Unified Memory; das ganze Modell passt in den Speicher. Parallele Vergleichsläufe.
- Identische Modelldateien, Modellversion und Strata-Version auf allen Systemen; identische Aufgaben und übereinstimmende Wiederholungen.
Was gemessen wird
- Nutzen bei realen Aufgaben mit begrenzter Hardware.
- Degradation bei großen Kontextfenstern.
- Antwortqualität auf unterschiedlicher Hardware.
- Ob das Modell seine eigene Arbeit verbessern kann: Fehler finden, beheben und in einer kontinuierlichen Schleife verhindern.
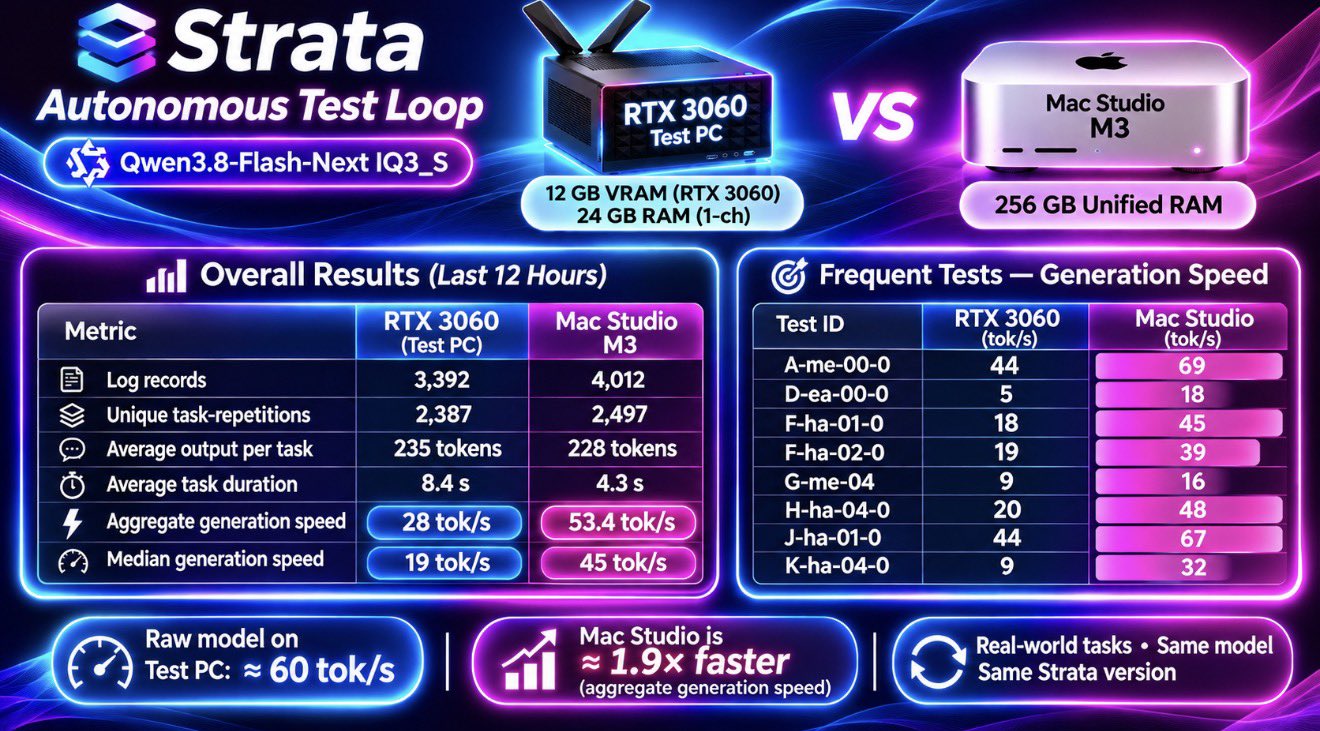
Geschwindigkeit, letzte 12 Stunden
| Kennzahl | RTX 3060 | Mac Studio M3 |
|---|---|---|
| Log-Einträge | 3392 | 4012 |
| Eindeutige Aufgabenwiederholungen | 2387 | 2497 |
| Durchschnittliche Ausgabe pro Aufgabe, Token | 235 | 228 |
| Durchschnittliche Aufgabendauer, s | 8.4 | 4.3 |
| Aggregierte Generierungsgeschwindigkeit, tok/s | 28 | 53.4 |
| Median der Generierungsgeschwindigkeit, tok/s | 19 | 45 |
| Aufgaben-ID | RTX 3060, tok/s | Mac Studio M3, tok/s |
|---|---|---|
| A-me-00-0 | 44 | 69 |
| D-ea-00-0 | 5 | 18 |
| F-ha-01-0 | 18 | 45 |
| F-ha-02-0 | 19 | 39 |
| G-me-04 | 9 | 16 |
| H-ha-04-0 | 20 | 48 |
| J-ha-01-0 | 44 | 67 |
| K-ha-04-0 | 9 | 32 |
Die aggregierte Generierungsgeschwindigkeit ist auf dem Mac Studio etwa 1,9-mal höher. Das reine Modell auf dem Experiment-PC erreicht etwa 60 tok/s. Hermes generiert schneller, hat aber eine andere Last, daher wäre ein direkter Vergleich irreführend.
Antwortqualität: v1.8 und v1.9
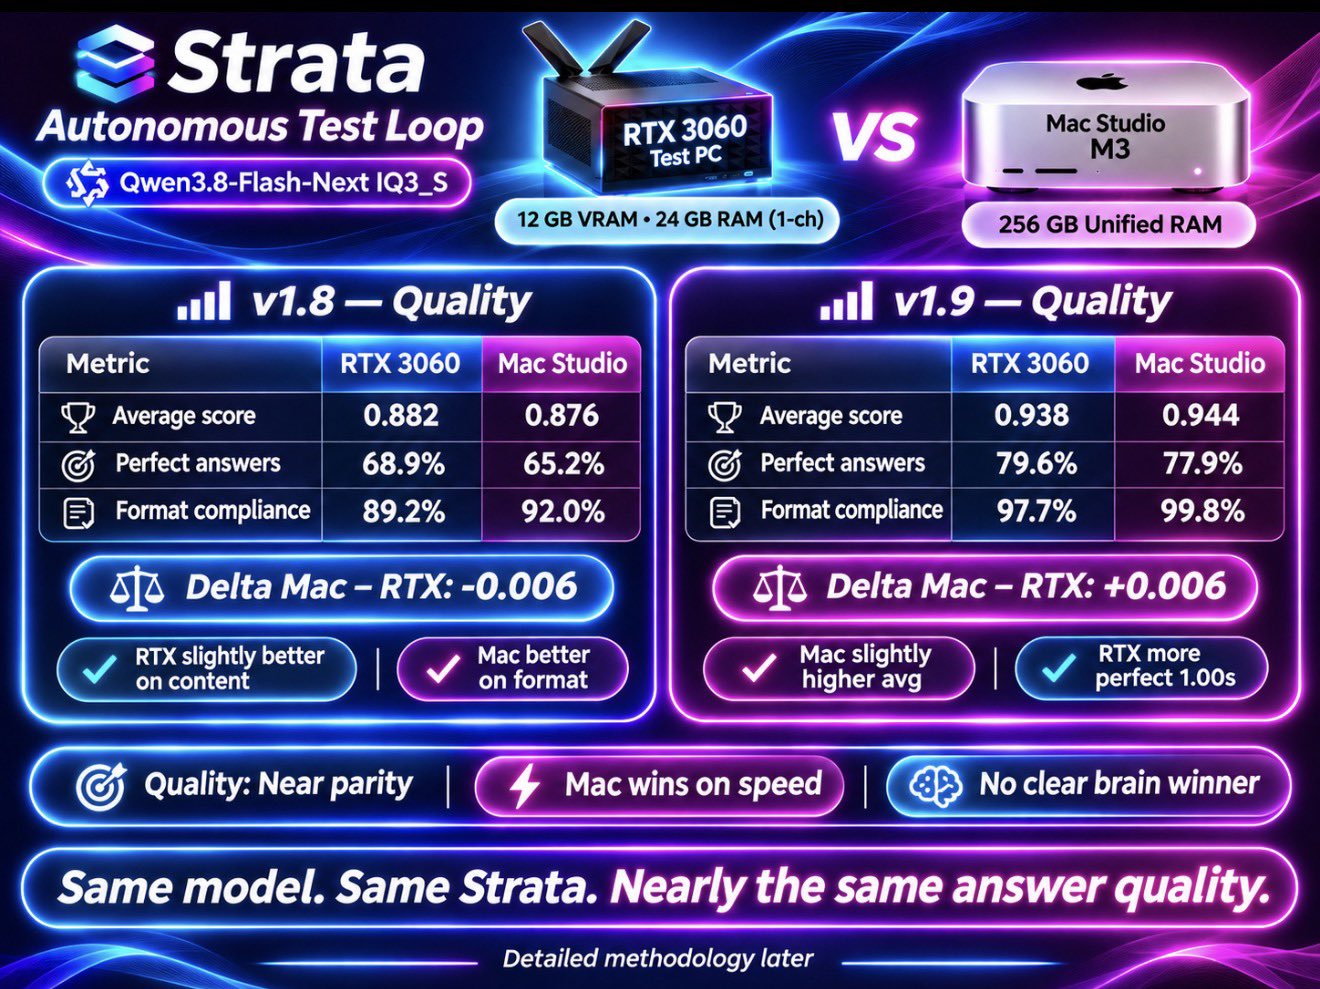
| Kennzahl | RTX 3060 v1.8 | Mac Studio v1.8 | RTX 3060 v1.9 | Mac Studio v1.9 |
|---|---|---|---|---|
| Durchschnittliche Bewertung | 0.882 | 0.876 | 0.938 | 0.944 |
| Perfekte Antworten, % | 68.9 | 65.2 | 79.6 | 77.9 |
| Formattreue, % | 89.2 | 92.0 | 97.7 | 99.8 |
| Differenz Mac − RTX | −0.006 | +0.006 | ||
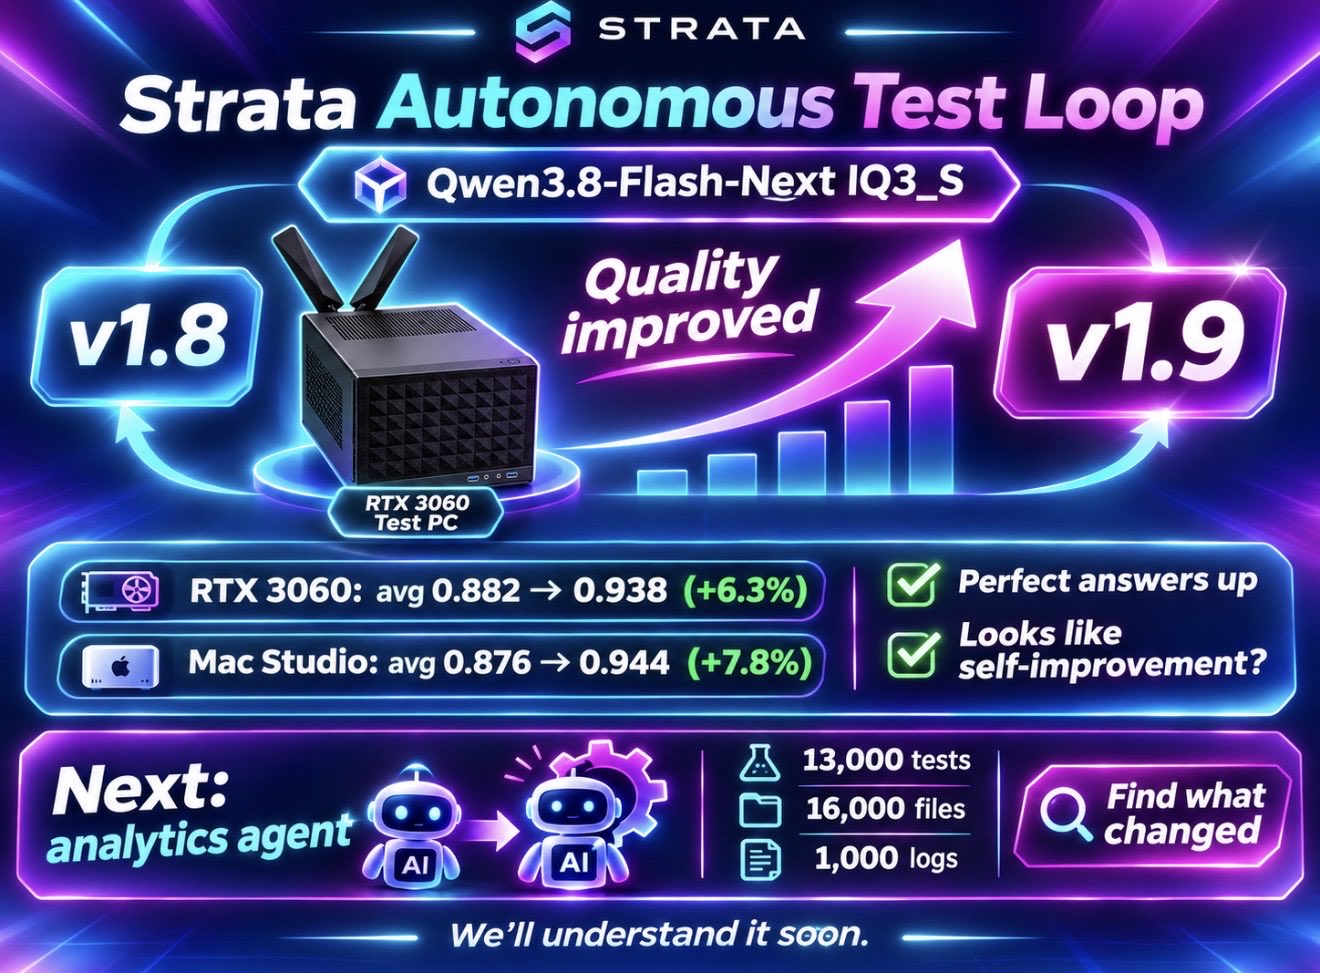
Die Qualität ist nahezu gleich; bei der Geschwindigkeit liegt der Mac vorn. Von v1.8 zu v1.9 stieg die durchschnittliche Bewertung um 6,3 % auf der RTX 3060 und um 7,8 % auf dem Mac Studio; auch der Anteil perfekter Antworten stieg. Unterschiede nach Kategorien werden noch analysiert.
Verhalten des Agenten
Ohne Hinweis in den Prompts begann der Agent, die Token-Kosten seiner Verbesserungen abzuschätzen und in einigen Versionen seine Prozesse zu optimieren, um unnötigen Token-Verbrauch zu senken.
Als Nächstes
Gesammelt: 13.000 Durchläufe, 16.000 Dateien, 1.000 Log-Dateien. Eine Demo eines Analysesystems wird gebaut, um die Ergebnisse dieses Experiments tiefer zu analysieren.