
Cinco días de desarrollo autónomo de IA local: del 77 % al 99 %
Cinco días de un entorno de desarrollo experimental auto-mejorante alrededor de un modelo local congelado: calidad, velocidad, coste y puntos abiertos.
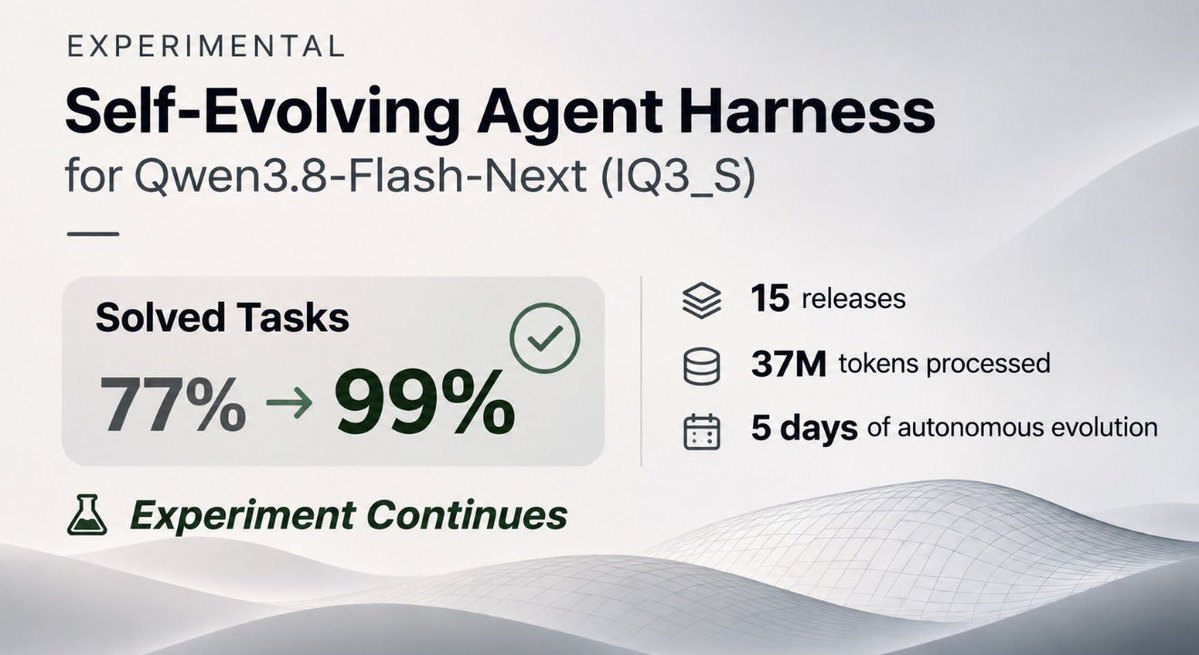
Entre el 31 de octubre y el 5 de noviembre de 2026, un entorno de desarrollo experimental para Qwen3.8-Flash-Next IQ3_S elevó la parte de tareas perfectamente resueltas del 77 % al 99 % en un conjunto fijo de 178 tareas (facturas, hojas, diagnóstico, código y filtros). No se afinaron los pesos del modelo.
La inferencia pasó de Strata a Basalt. El decode subió de unos 80 a 130–220 tok/s; el prefill se duplicó aproximadamente; un benchmark completo bajó de 87 minutos a 6,9. El entorno de desarrollo tuvo 15 versiones con controles contractuales.
En las máquinas de benchmark hubo unos 34.000 llamamientos al modelo y unos 37 millones de tokens procesados (unos 4 millones de tokens de respuesta útiles). Tiempo de calendario: 120 horas; gran parte de la capacidad quedó inactiva por cambios de hardware, reinicios y esperas de decisiones humanas.
Coste estimado del mismo volumen por API comerciales (33M de entrada y 4M de salida, tarifas estándar, sin caché): Qwen Flash unos 3,25 $; DeepSeek Flash 7–15 $; Gemini 2.5 Flash unos 20 $; GPT-5.4 Mini unos 43 $; Grok 4.3 unos 51 $; Claude Sonnet 5.5 unos 106 $; GPT-5.4 unos 143 $. Electricidad local en cinco días: unos 7–10 € a 0,25 €/kWh, idle incluido. Es una comprobación de escala, no la tesis de que la IA local siempre sea más barata o de que los modelos sean iguales.
Frente a una línea base de modelo en bruto con el mismo presupuesto de cómputo (best-of-2 a ciegas), el entorno de desarrollo marcó +13,5 puntos porcentuales. Hay pasadas holdout para ver si las ganancias se mantienen en tareas no vistas. Versiones, método y benchmarks están en GitHub.