
Costes energéticos preliminares de la IA local en una carga real
Costes eléctricos preliminares de una ejecución de IA local, comparados con los precios de API en la nube indicados para el mismo número de tokens.
Se han recogido cifras preliminares de consumo energético a partir de cargas reales de IA local, mediante mediciones y registros del sistema. Las cifras siguen siendo estimaciones, pero ofrecen una imagen bastante precisa de la economía general.
Las mediciones se realizaron en un portátil eficiente con una GPU moderna, de unos 4.000–4.500 dólares (4.000–4.500 €). En hardware menos eficiente, los costes de electricidad probablemente serán más altos y pueden acercarse a los precios de API de los modelos chinos más baratos. Esos modelos suelen estar disponibles de forma gratuita o con descuentos de hasta el 90 %. En esos casos, la IA en la nube puede ser más barata que la sola electricidad necesaria para la inferencia local.
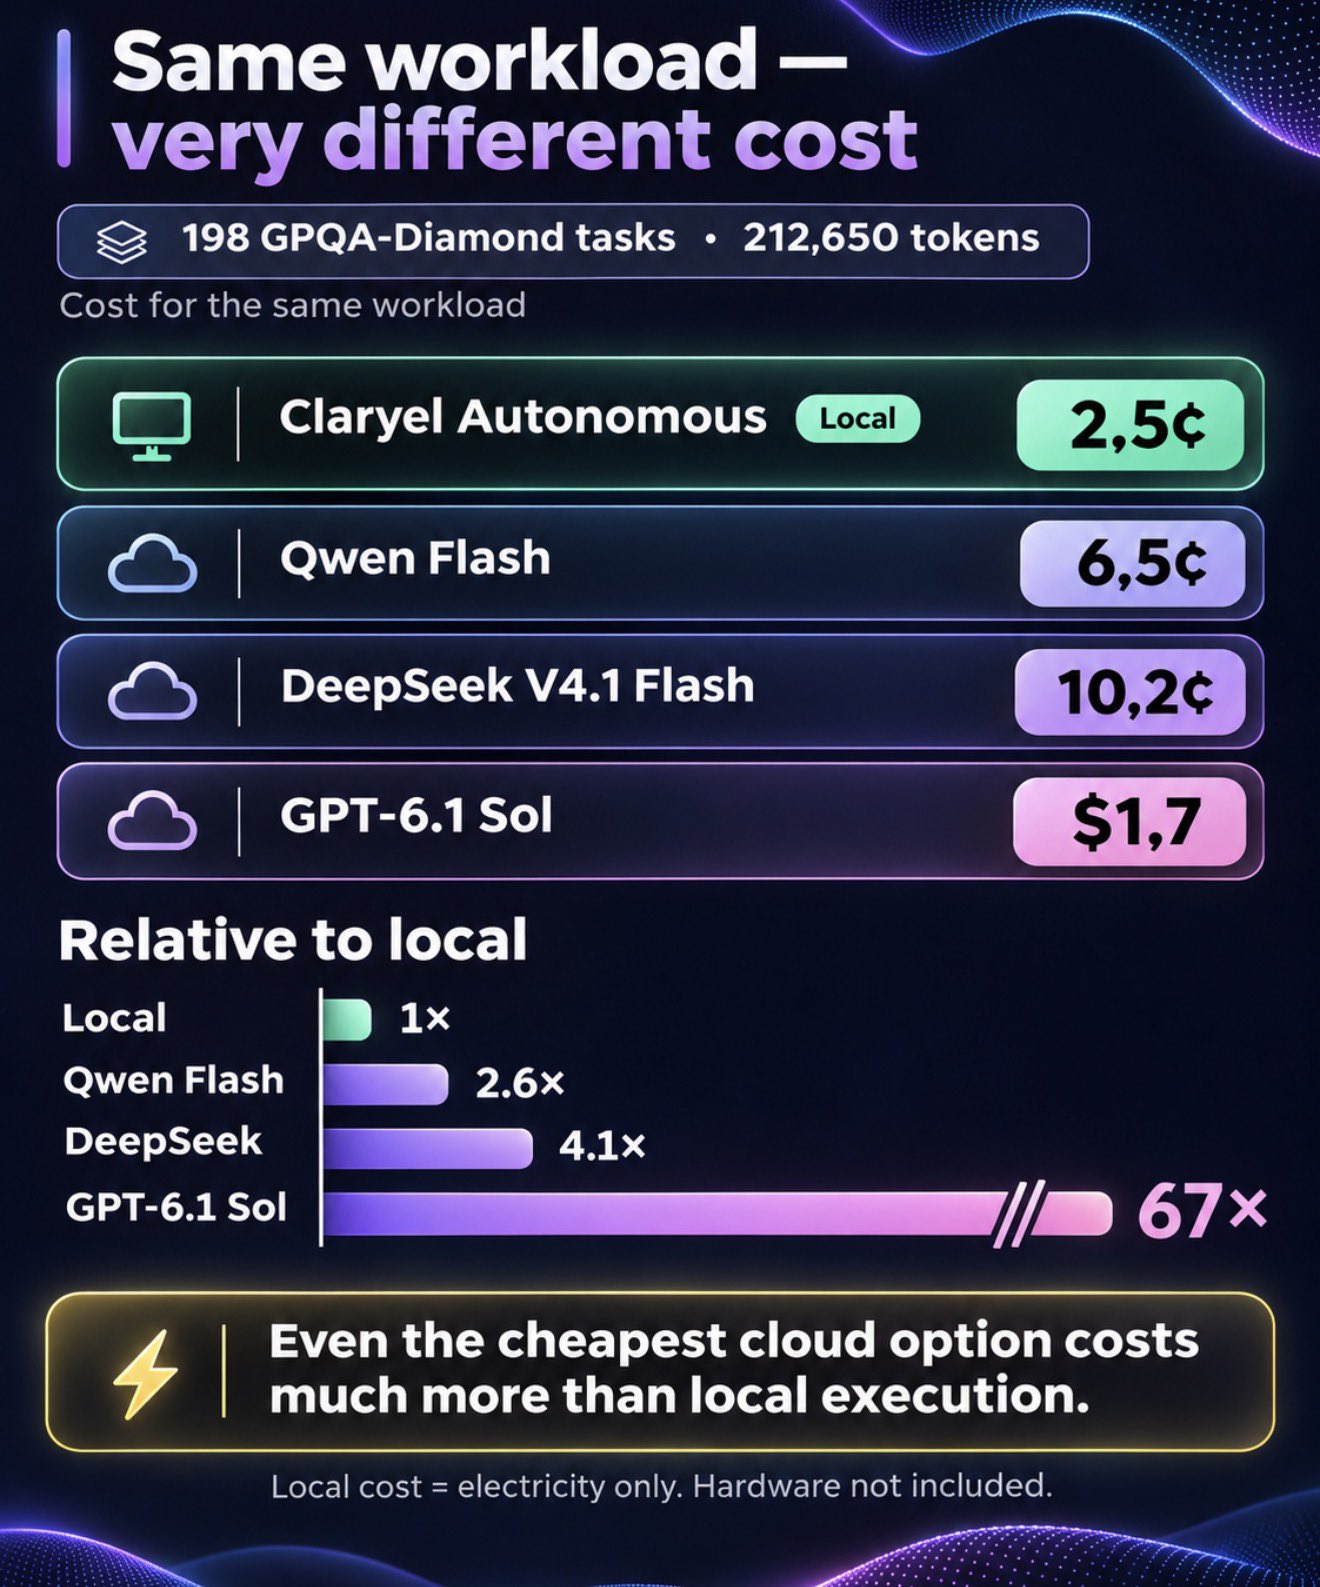
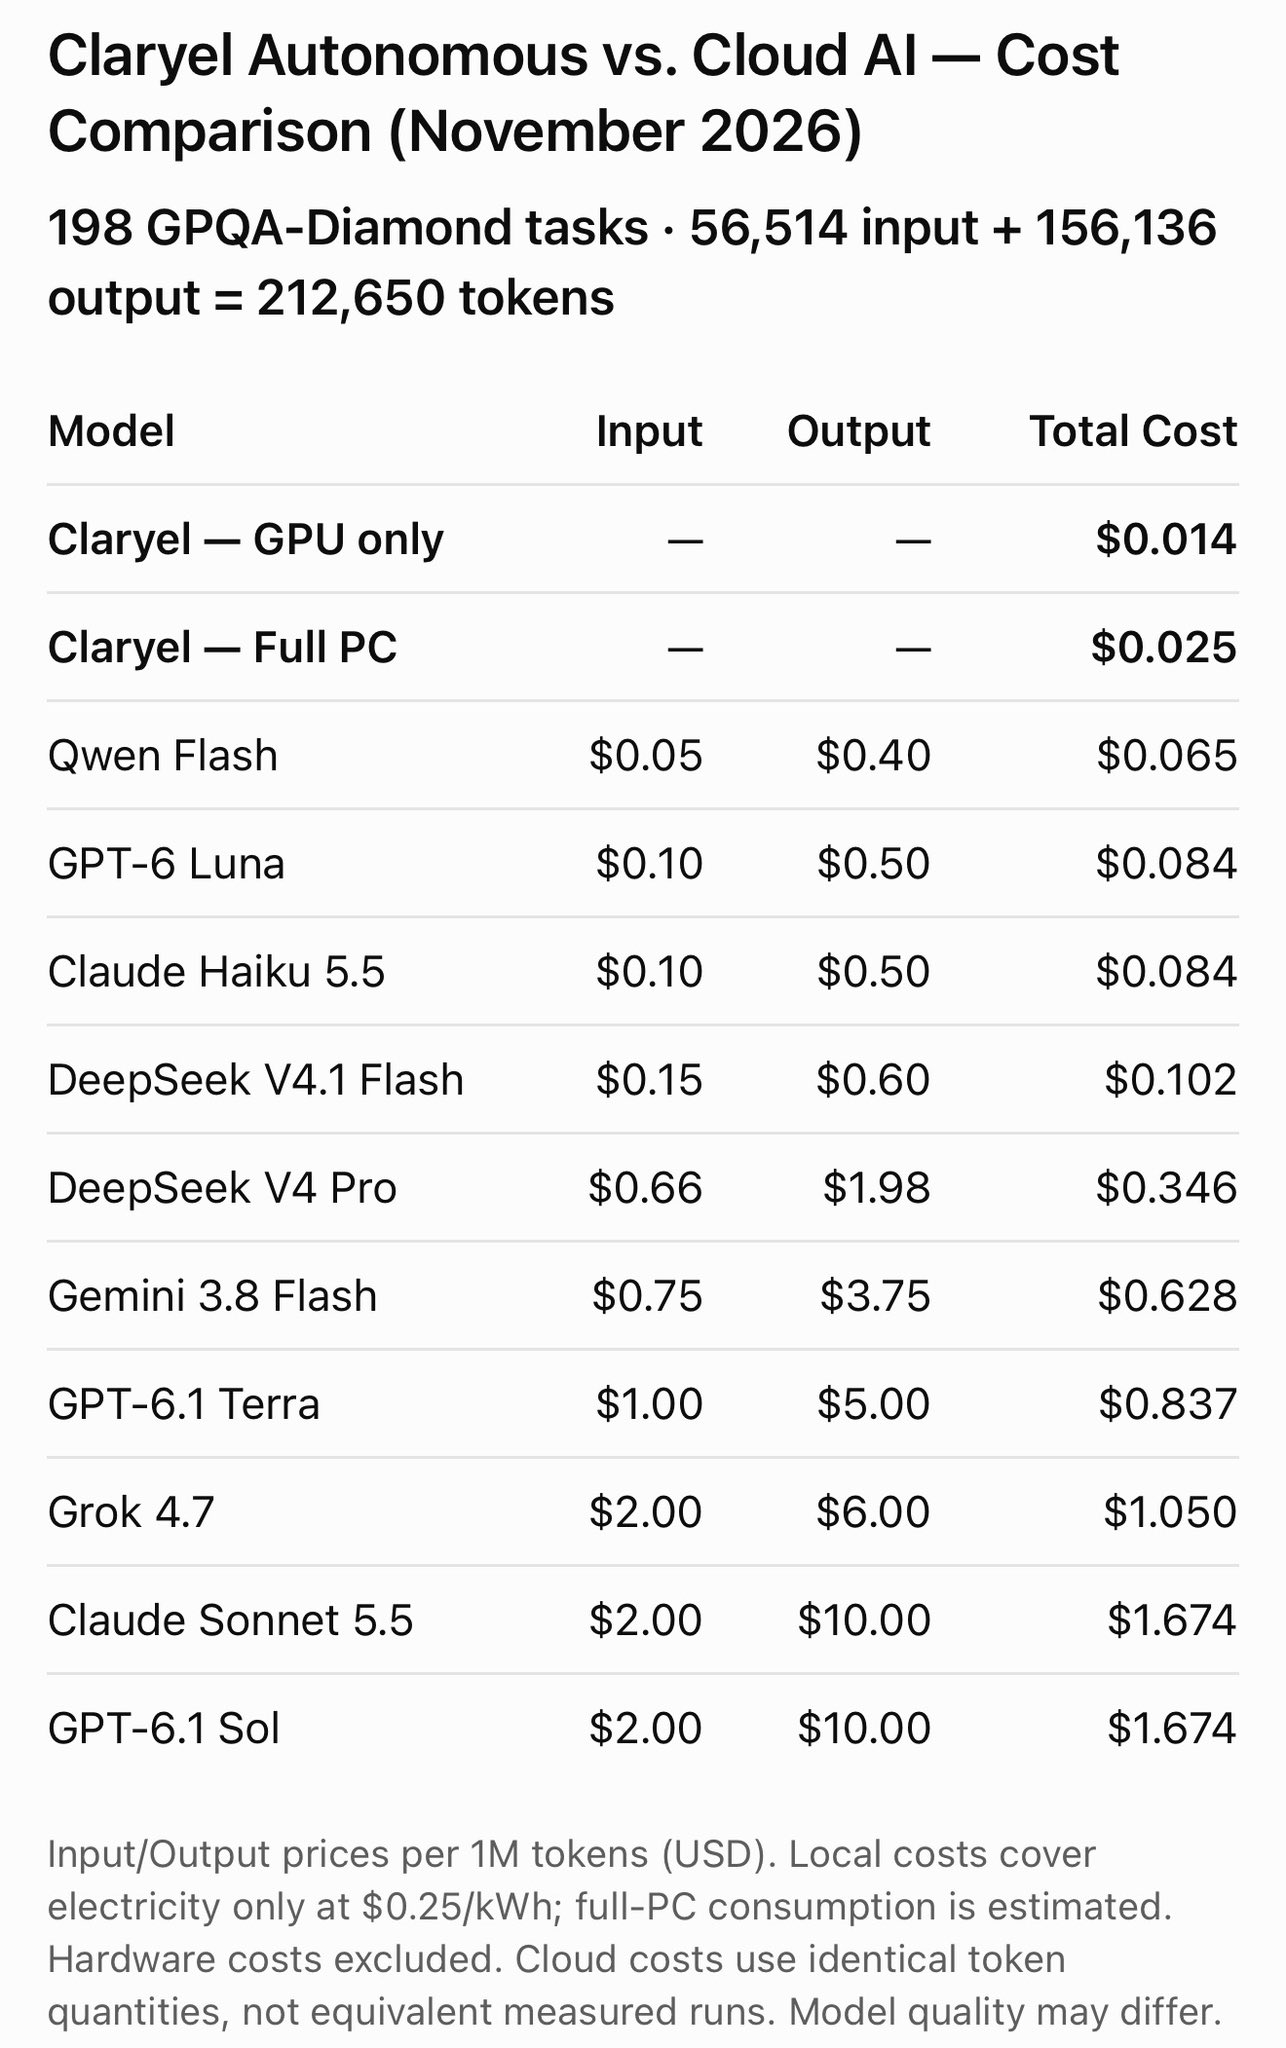
Los gráficos publicados con la publicación comparan una carga — 198 tareas GPQA-Diamond, 56.514 tokens de entrada y 156.136 de salida, 212.650 tokens en total — con electricidad a 0,25 $/kWh. Los costes locales en la tabla son 0,014 $ solo para la GPU y 0,025 $ para el PC completo estimado. Los totales en la nube indicados para el mismo número de tokens van de 0,065 $ (Qwen Flash) a 1,674 $ (Claude Sonnet 5.5 y GPT-6.1 Sol). Una nota de la tabla indica que el hardware está excluido, que los costes en la nube usan las mismas cantidades de tokens y no ejecuciones equivalentes medidas, y que la calidad de los modelos puede diferir.
Son resultados preliminares. Se prevén más mediciones, y los hallazgos se publicarán en GitHub.