
Cinq jours de développement autonome d’IA locale : de 77 % à 99 %
Cinq jours d’un environnement de développement expérimental auto-améliorant autour d’un modèle local figé : qualité, vitesse, coût et questions ouvertes.
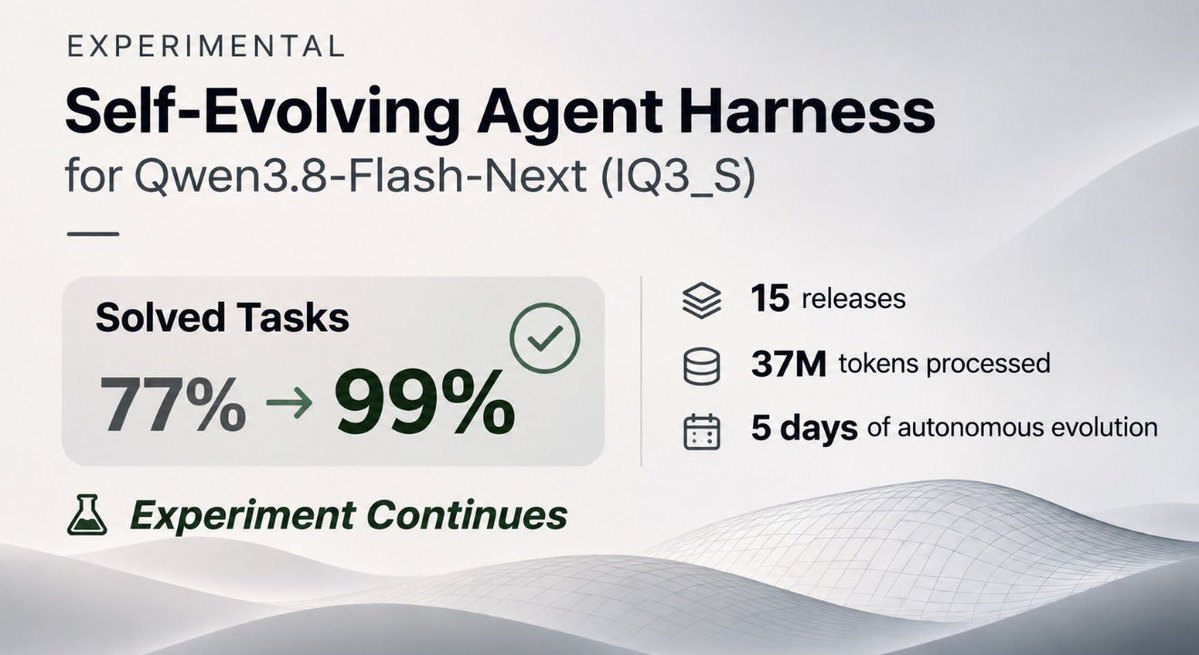
Entre le 31 octobre et le 5 novembre 2026, un environnement de développement expérimental pour Qwen3.8-Flash-Next IQ3_S a porté la part de tâches parfaitement résolues de 77 % à 99 % sur un jeu fixe de 178 tâches (factures, tableurs, diagnostic, code et filtres). Les poids du modèle n’ont pas été affinés.
L’inférence est passée de Strata à Basalt. Le décodage est passé d’environ 80 à 130–220 tok/s ; le prefill a environ doublé ; un benchmark complet est passé de 87 minutes à 6,9. L'environnement de développement a connu 15 versions avec contrôles contractuels.
Sur les machines de benchmark : environ 34 000 appels modèle et environ 37 millions de jetons traités (environ 4 millions de jetons de réponse utiles). Temps calendaire : 120 heures ; une grande part de capacité est restée inactive à cause de changements matériels, redémarrages et attentes de décisions humaines.
Coût estimé du même volume via API commerciales (33M entrée et 4M sortie, tarifs standards, sans cache) : Qwen Flash environ 3,25 $ ; DeepSeek Flash 7–15 $ ; Gemini 2.5 Flash environ 20 $ ; GPT-5.4 Mini environ 43 $ ; Grok 4.3 environ 51 $ ; Claude Sonnet 5.5 environ 106 $ ; GPT-5.4 environ 143 $. Électricité locale sur cinq jours : environ 7–10 € à 0,25 €/kWh, idle inclus. C’est un contrôle d’échelle, pas l’affirmation que l’IA locale est toujours moins chère ou que les modèles sont égaux.
Face à une baseline de modèle brut à budget de calcul égal (best-of-2 aveugle), l'environnement de développement a marqué +13,5 points de pourcentage. Des passes holdout vérifient si les gains tiennent sur des tâches non vues. Versions, méthode et benchmarks sont sur GitHub.