
Cinque giorni di sviluppo autonomo di IA locale: dal 77% al 99%
Cinque giorni di un ambiente di sviluppo sperimentale auto-migliorante intorno a un modello locale congelato: qualità, velocità, costo e punti aperti.
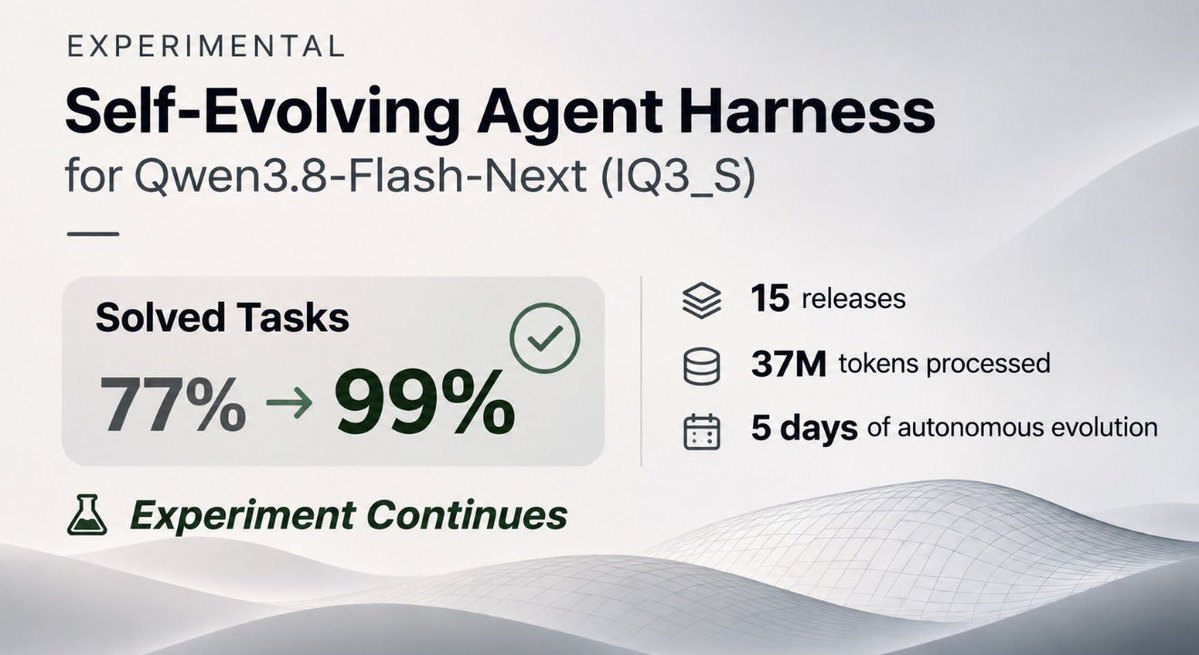
Tra il 31 ottobre e il 5 novembre 2026 un ambiente di sviluppo sperimentale per Qwen3.8-Flash-Next IQ3_S ha portato la quota di task risolti alla perfezione dal 77% al 99% su un set fisso di 178 task (fatture, fogli, diagnostica, codice e filtri). I pesi del modello non sono stati fine-tuned.
L'inferenza è passata da Strata a Basalt. Il decode è salito da circa 80 a 130–220 tok/s; il prefill è circa raddoppiato; un benchmark completo è sceso da 87 minuti a 6,9. L'ambiente di sviluppo ha avuto 15 release con controlli contrattuali.
Sulle macchine usate per i benchmark ci sono stati circa 34.000 richiami al modello e circa 37 milioni di token elaborati (circa 4 milioni di token di risposta utili). Il tempo di calendario è 120 ore; gran parte della capacità è restata inattiva per cambi hardware, riavvii e attese di decisioni umane.
Costo stimato dello stesso volume di token via API commerciali (33M input e 4M output, tariffe standard, senza cache): Qwen Flash circa 3,25 $; DeepSeek Flash 7–15 $; Gemini 2.5 Flash circa 20 $; GPT-5.4 Mini circa 43 $; Grok 4.3 circa 51 $; Claude Sonnet 5.5 circa 106 $; GPT-5.4 circa 143 $. L'elettricità locale in cinque giorni è stimata in 7–10 € a 0,25 €/kWh, idle incluso. È un controllo di scala, non la tesi che l'IA locale costi sempre meno o che i modelli siano uguali.
Contro una baseline di modello grezzo a budget di calcolo pari (best-of-2 cieco), l'ambiente di sviluppo ha segnato +13,5 punti percentuali. Sono in corso run di holdout per verificare i guadagni su task non visti. Release, metodo e benchmark sono su GitHub.