
Pięć dni autonomicznego rozwoju lokalnej AI: z 77% do 99%
Pięć dni eksperymentalnego, samodoskonalącego się środowiska deweloperskiego wokół zamrożonego lokalnego modelu: jakość, szybkość, koszt i otwarte kwestie.
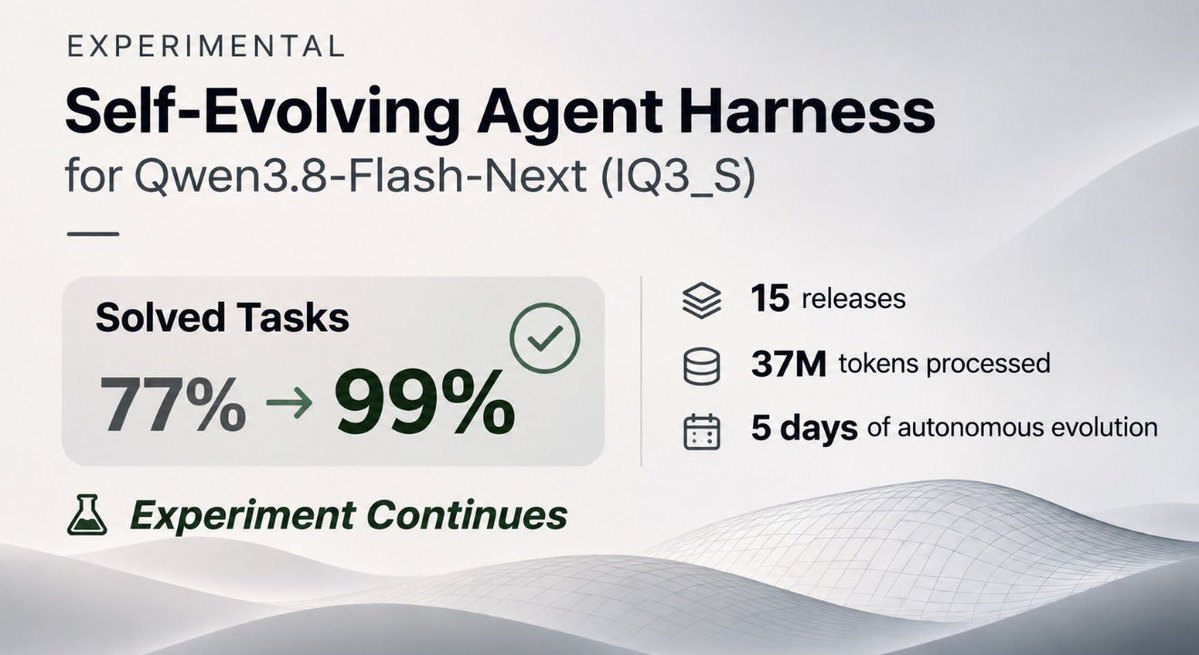
Między 31 października a 5 listopada 2026 eksperymentalne środowisko deweloperskie dla Qwen3.8-Flash-Next IQ3_S podniosło udział idealnie rozwiązanych zadań z 77% do 99% na stałym zestawie 178 zadań (faktury, tabele, diagnostyka, kod i filtrowanie). Wag modelu nie dogrywano.
Wnioskowanie przeniesiono ze Strata na Basalt. Decode wzrosło z ok. 80 do 130–220 tok/s; prefill mniej więcej się podwoił; pełny przebieg benchmarku skrócił się z 87 minut do 6,9. Środowisko deweloperskie przeszło 15 wydań z kontrolami kontraktowymi.
Na maszynach używanych do przebiegów benchmarku było około 34 000 wywołań modelu i około 37 milionów tokenów. Praca biegła autonomicznie według stałych reguł, z przeglądami ludzkimi w punktach decyzyjnych.
Szacunkowy koszt tej samej ilości tokenów przez komercyjne API (przyjmując 33M wejścia i 4M wyjścia, typowe ceny publiczne): rzędu kilku tysięcy dolarów. Lokalny przebieg użył sprzętu już dostępnego w laboratorium.
Wobec linii bazowej surowego modelu przy tym samym budżecie obliczeń (ślepe best-of-2) środowisko deweloperskie uzyskało +13,5 punktu procentowego. Trwają przebiegi holdout, by sprawdzić odporność na nieznanych zadaniach. Wydania, metoda i benchmarki — na GitHub.