
Aktualności
Autonomiczna pętla Strata: RTX 3060 kontra Mac Studio M3, pierwsze wyniki
Jeden model (Qwen3.8-Flash-Next IQ3_S), te same pliki i ta sama wersja Strata na dwóch bardzo różnych konfiguracjach. Dane z ostatnich 12 godzin.
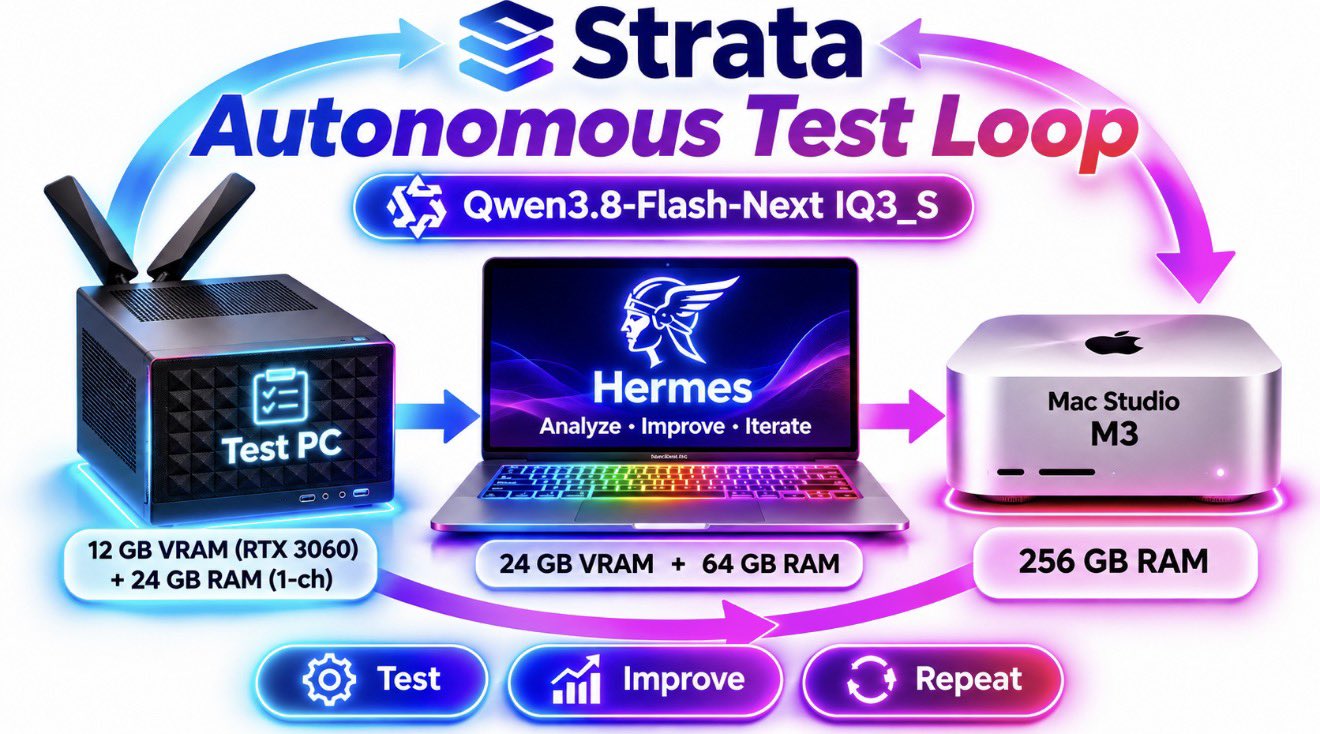
Konfiguracja
- PC do eksperymentów: RTX 3060 z 12 GB VRAM i 24 GB jednokanałowej RAM; skrajnie ograniczona pamięć i agresywne ustawienia uruchomieniowe. Pracuje 24/7.
- Hermes (komputer P2005): 24 GB VRAM i 64 GB RAM. Analizuje wyniki, weryfikuje pracę, wprowadza ulepszenia.
- Mac Studio M3: 256 GB pamięci zunifikowanej; cały model mieści się w pamięci. Równoległe przebiegi porównawcze.
- Identyczne pliki modelu, wersja modelu i wersja Strata na wszystkich systemach; identyczne zadania i odpowiadające sobie powtórzenia.
Co jest mierzone
- Użyteczność w rzeczywistych zadaniach na ograniczonym sprzęcie.
- Degradacja przy dużych oknach kontekstu.
- Jakość odpowiedzi na różnym sprzęcie.
- Czy model potrafi sam ulepszać swoją pracę: znajdować błędy, poprawiać je i im zapobiegać w ciągłej pętli.
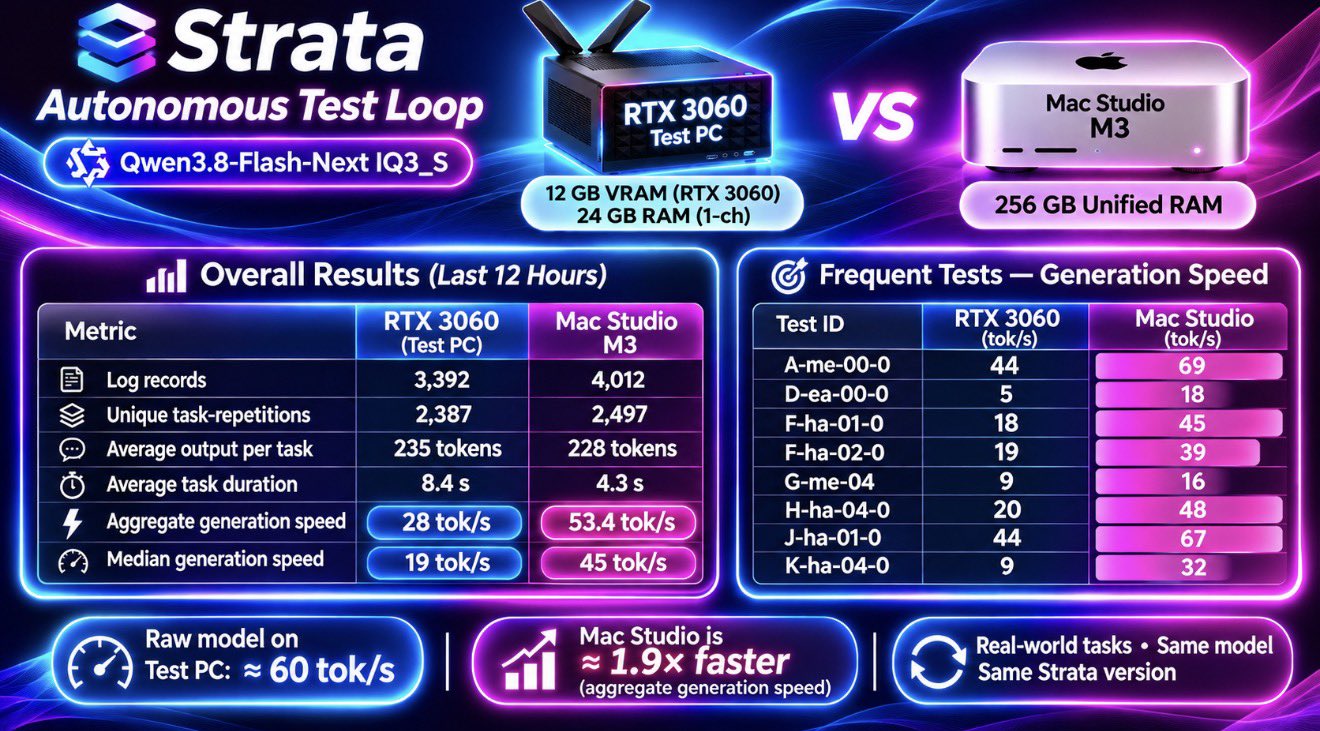
Szybkość, ostatnie 12 godzin
| Wskaźnik | RTX 3060 | Mac Studio M3 |
|---|---|---|
| Wpisy w logach | 3392 | 4012 |
| Unikalne powtórzenia zadań | 2387 | 2497 |
| Średnie wyjście na zadanie, tokeny | 235 | 228 |
| Średni czas zadania, s | 8.4 | 4.3 |
| Łączna szybkość generowania, tok/s | 28 | 53.4 |
| Mediana szybkości generowania, tok/s | 19 | 45 |
| ID zadania | RTX 3060, tok/s | Mac Studio M3, tok/s |
|---|---|---|
| A-me-00-0 | 44 | 69 |
| D-ea-00-0 | 5 | 18 |
| F-ha-01-0 | 18 | 45 |
| F-ha-02-0 | 19 | 39 |
| G-me-04 | 9 | 16 |
| H-ha-04-0 | 20 | 48 |
| J-ha-01-0 | 44 | 67 |
| K-ha-04-0 | 9 | 32 |
Łączna szybkość generowania jest na Mac Studio około 1,9 razy wyższa. Sam model na PC do eksperymentów osiąga około 60 tok/s. Hermes generuje szybciej, ale ma inne obciążenie, więc bezpośrednie porównanie byłoby mylące.
Jakość odpowiedzi: v1.8 i v1.9
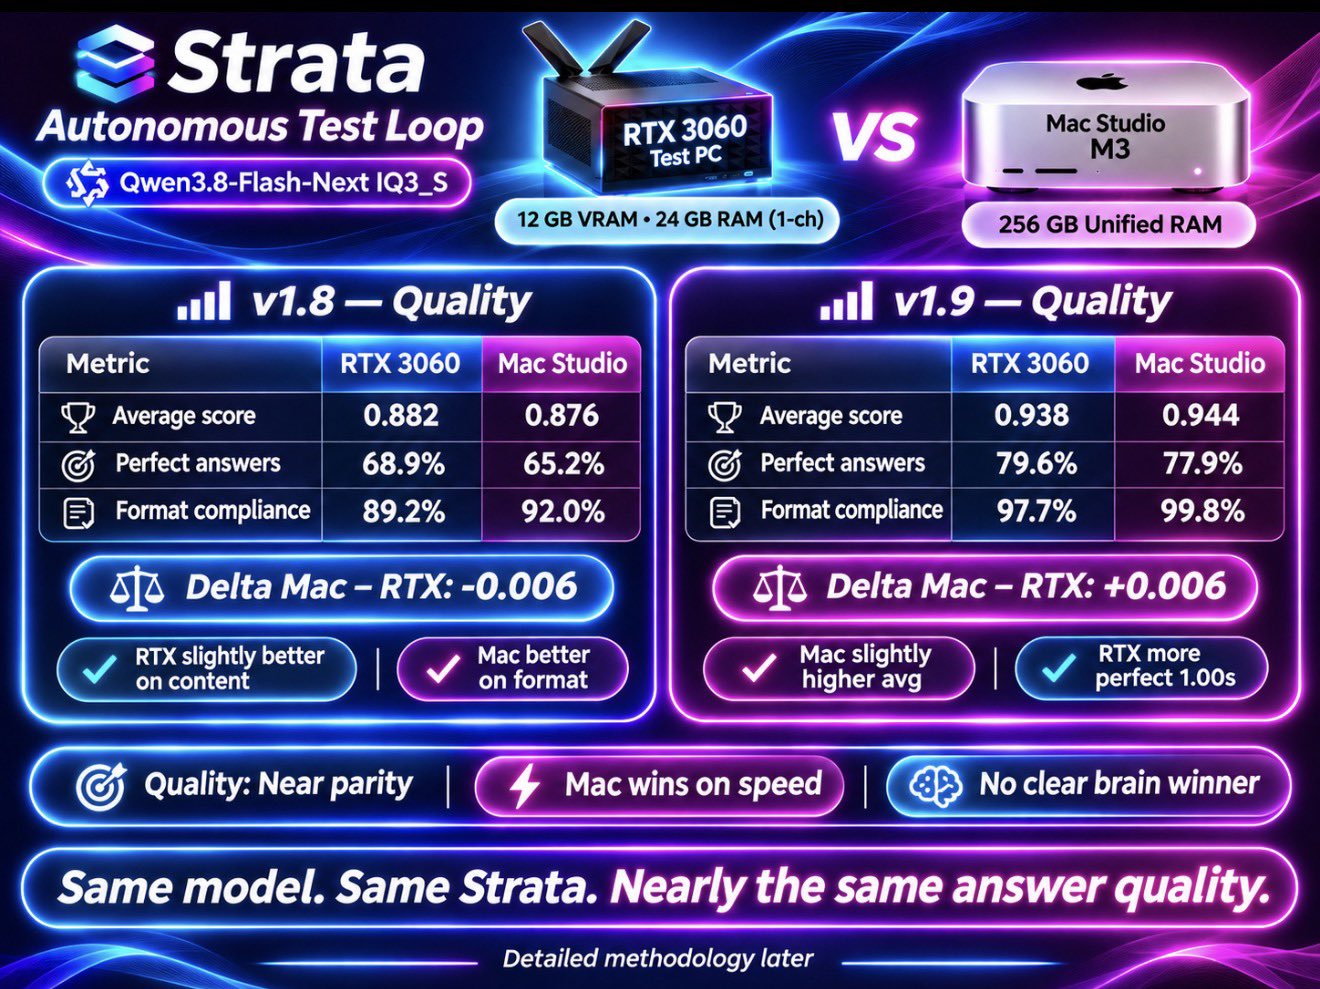
| Wskaźnik | RTX 3060 v1.8 | Mac Studio v1.8 | RTX 3060 v1.9 | Mac Studio v1.9 |
|---|---|---|---|---|
| Średnia ocena | 0.882 | 0.876 | 0.938 | 0.944 |
| Idealne odpowiedzi, % | 68.9 | 65.2 | 79.6 | 77.9 |
| Zgodność z formatem, % | 89.2 | 92.0 | 97.7 | 99.8 |
| Różnica Mac − RTX | −0.006 | +0.006 | ||
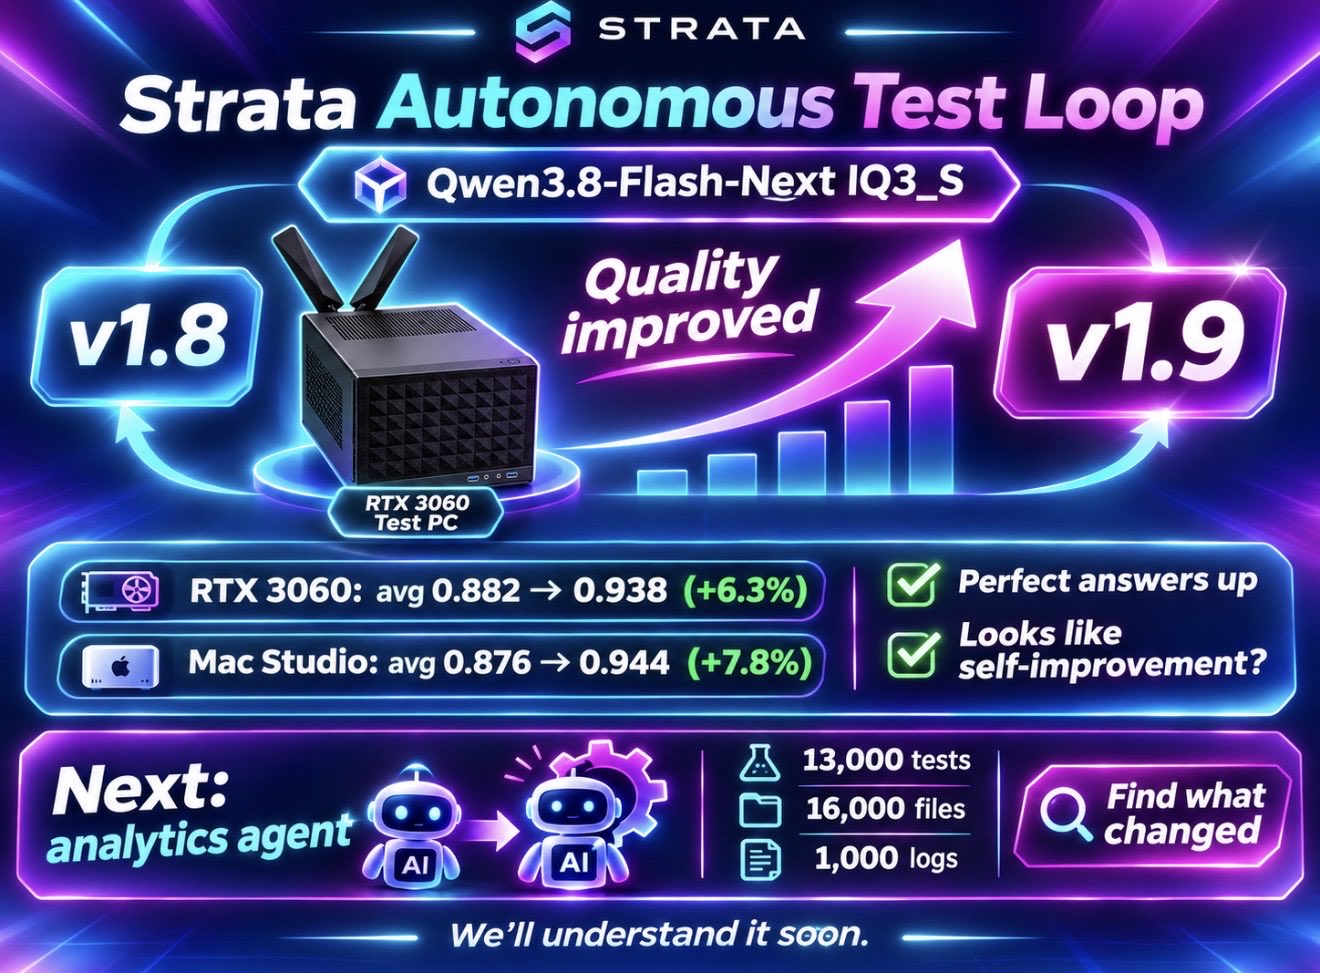
Jakość jest niemal równa; w szybkości wygrywa Mac. Od v1.8 do v1.9 średnia ocena wzrosła o 6,3% na RTX 3060 i o 7,8% na Mac Studio; wzrósł też odsetek idealnych odpowiedzi. Różnice według kategorii są jeszcze analizowane.
Zachowanie agenta
Bez wskazówek w promptach agent zaczął szacować koszt swoich ulepszeń w tokenach, a w niektórych wersjach optymalizować procesy, by ograniczyć zbędne zużycie tokenów.
Dalej
Zebrano: 13 000 przebiegów, 16 000 plików, 1 000 plików logów. Powstaje demo systemu analitycznego do głębszej analizy wyników tego eksperymentu.