
Preliminära energikostnader för lokal AI vid en verklig belastning
Preliminära elkostnader för en lokal AI-körning, jämförda med de angivna moln-API-priserna för samma antal token.
Preliminära energiförbrukningssiffror har samlats in från verkliga lokala AI-belastningar, med hjälp av mätningar och systemloggar. Siffrorna är fortfarande uppskattningar, men ger en tillräckligt korrekt bild av den samlade ekonomin.
Mätningarna gjordes på en energieffektiv bärbar dator med ett modernt GPU, till ett pris av cirka 4 000–4 500 dollar (4 000–4 500 €). På mindre energieffektiv hårdvara blir elkostnaderna sannolikt högre och kan närma sig API-priserna för de billigaste kinesiska modellerna. Dessa modeller är ofta tillgängliga kostnadsfritt eller med rabatter på upp till 90 %. I sådana fall kan moln-AI bli billigare än enbart den el som krävs för lokal inferens.
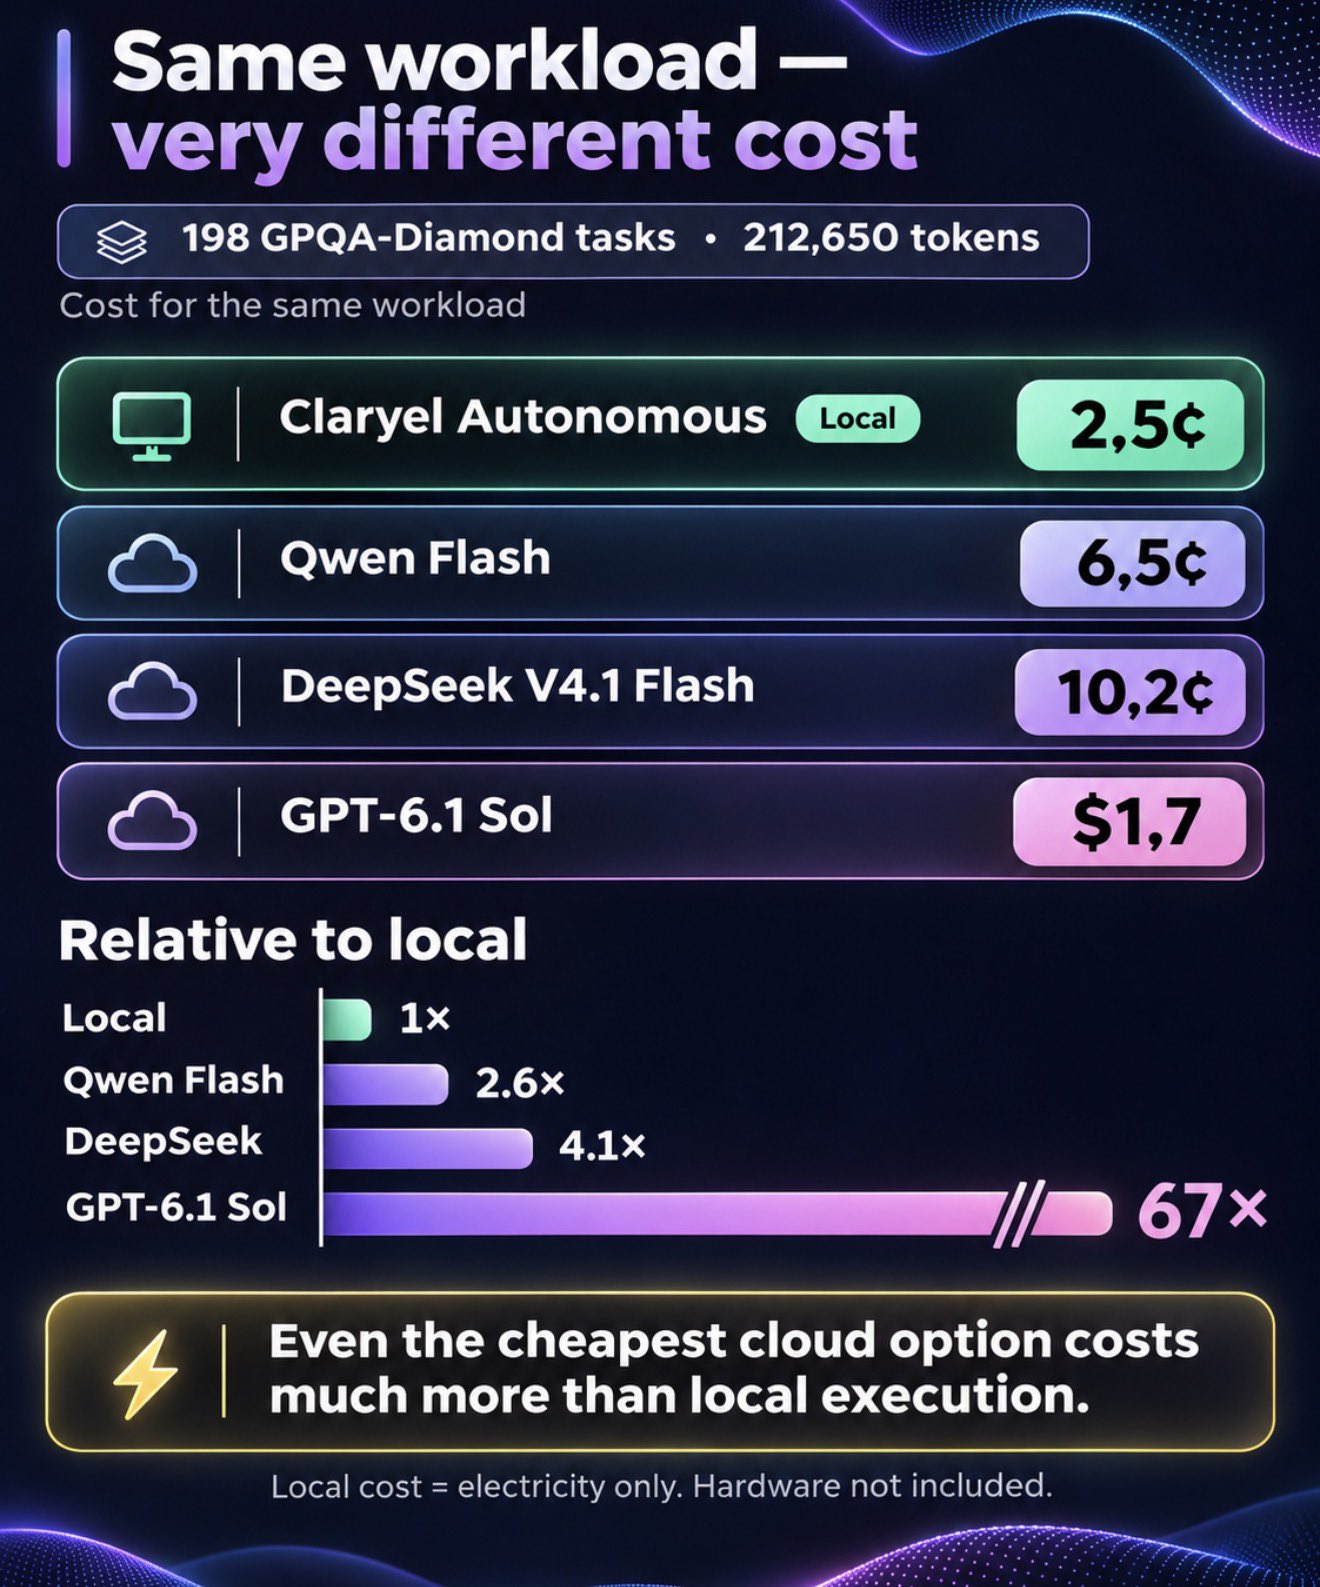
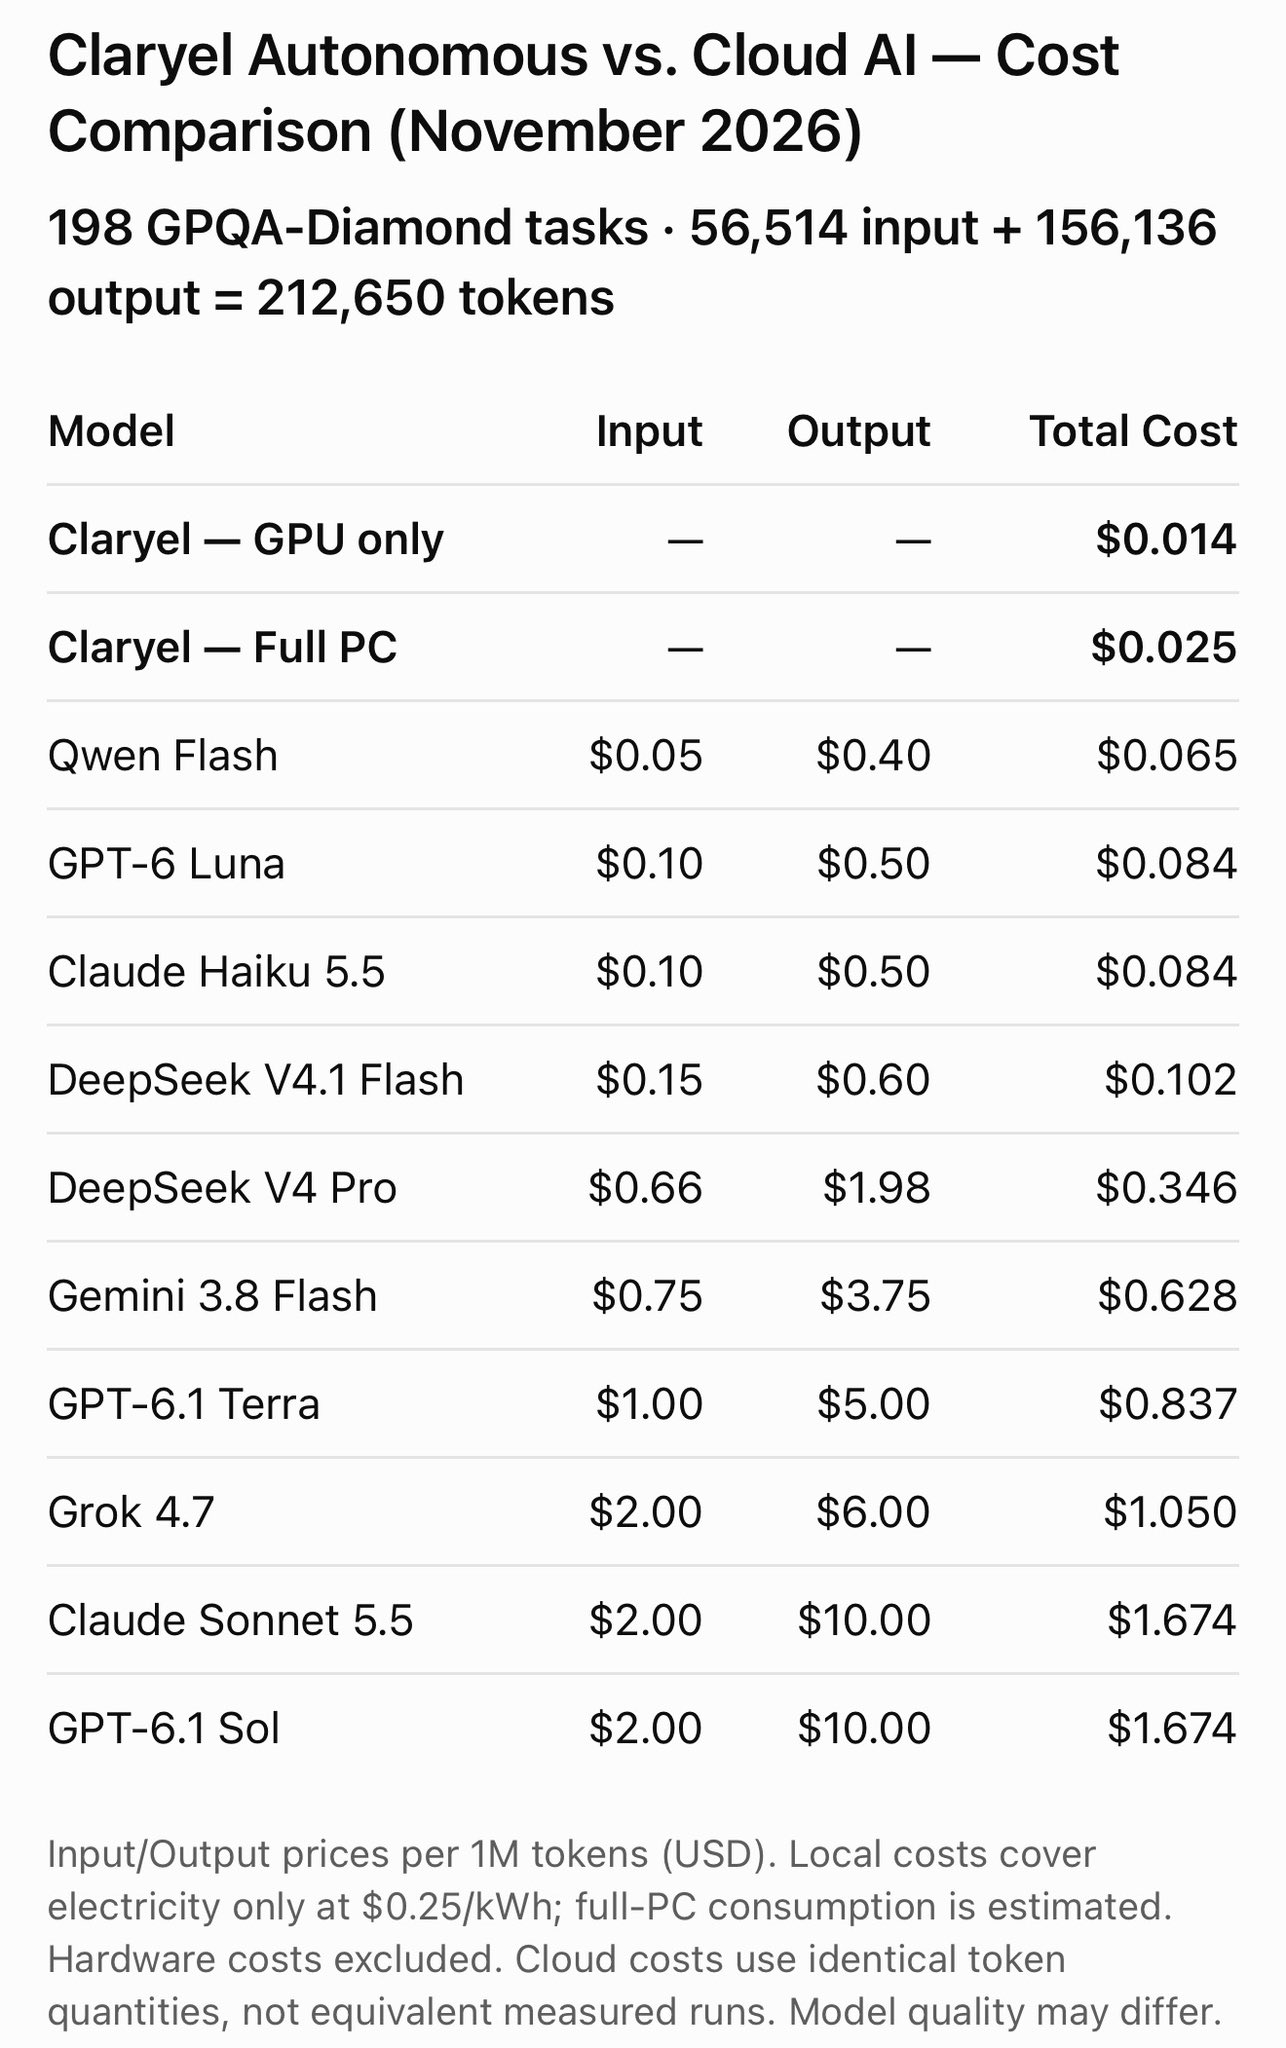
Diagrammen som publicerades med inlägget jämför en belastning — 198 GPQA-Diamond-uppgifter, 56 514 indata-token och 156 136 utdata-token, totalt 212 650 token — vid elpriset 0,25 $/kWh. De lokala kostnaderna i tabellen är 0,014 $ endast för GPU och 0,025 $ för den uppskattade hela datorn. De angivna molnsummorna för samma antal token sträcker sig från 0,065 $ (Qwen Flash) till 1,674 $ (Claude Sonnet 5.5 och GPT-6.1 Sol). En anmärkning i tabellen anger att hårdvara är undantagen, att molnkostnader använder identiska tokenmängder snarare än motsvarande uppmätta körningar, och att modellkvaliteten kan skilja sig.
Detta är preliminära resultat. Ytterligare mätningar planeras, och resultaten ska publiceras på GitHub.