
Lima hari pengembangan AI lokal otonom: dari 77% ke 99%
Lima hari lingkungan pengembangan eksperimental yang memperbaiki diri di sekitar model lokal yang dibekukan: kualitas, kecepatan, biaya, dan pertanyaan terbuka.
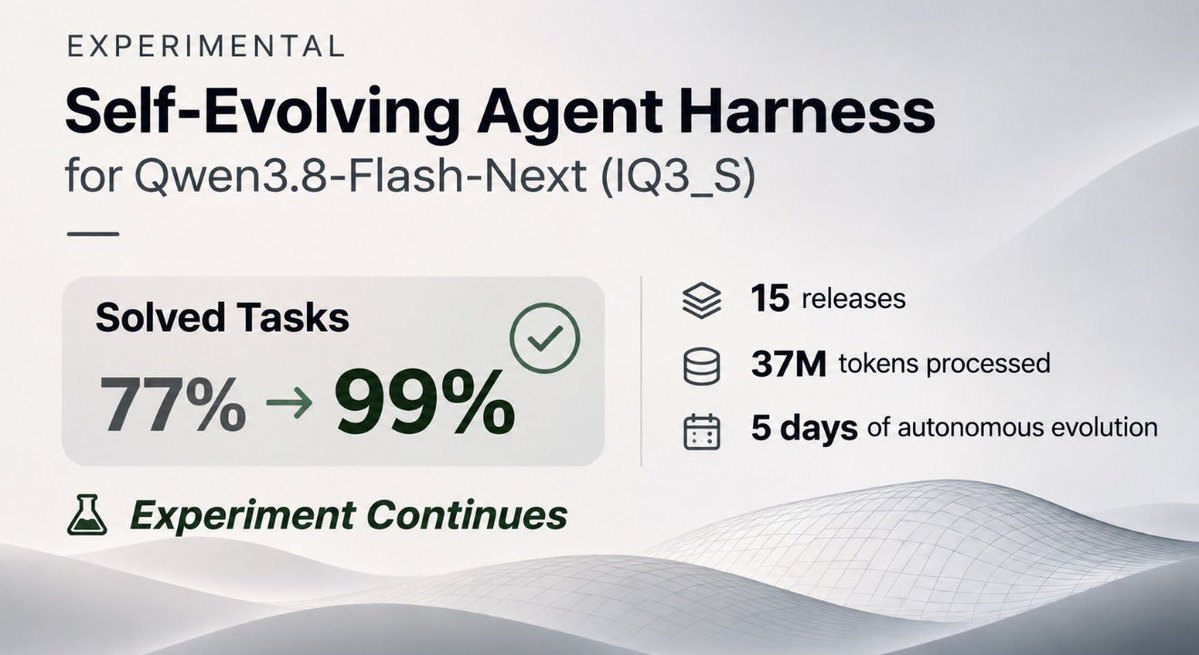
Antara 31 Oktober dan 5 November 2026, lingkungan pengembangan eksperimental untuk Qwen3.8-Flash-Next IQ3_S menaikkan porsi tugas yang diselesaikan sempurna dari 77% ke 99% pada set tetap 178 tugas (faktur, tabel, diagnostik, kode, dan penyaringan). Bobot model tidak dilatih ulang.
Inferensi berpindah dari Strata ke Basalt. Decode naik dari sekitar 80 ke 130–220 tok/s; prefill kira-kira berlipat dua; putaran tolok ukur penuh turun dari 87 menit ke 6,9. Lingkungan pengembangan melalui 15 rilis dengan pemeriksaan kontrak.
Pada mesin yang dipakai untuk putaran tolok ukur ada sekitar 34.000 panggilan model dan sekitar 37 juta token. Pekerjaan berjalan otonom di bawah aturan tetap, dengan tinjauan manusia pada titik keputusan.
Perkiraan biaya volume token yang sama lewat API komersial (asumsi 33 juta input dan 4 juta output, harga publik tipikal): orde ribuan dolar. Putaran lokal memakai perangkat keras yang sudah ada di laboratorium.
Terhadap baseline model mentah dengan anggaran komputasi yang sama (best-of-2 buta), lingkungan pengembangan mencatat +13,5 poin persentase. Putaran holdout sedang berjalan untuk memeriksa ketahanan pada tugas yang belum dikenal. Rilis, metode, dan tolok ukur ada di GitHub.