
Știri
Bucla autonomă Strata: RTX 3060 față de Mac Studio M3, primele rezultate
Un model (Qwen3.8-Flash-Next IQ3_S), aceleași fișiere și aceeași versiune Strata pe două configurații foarte diferite. Date din ultimele 12 ore.
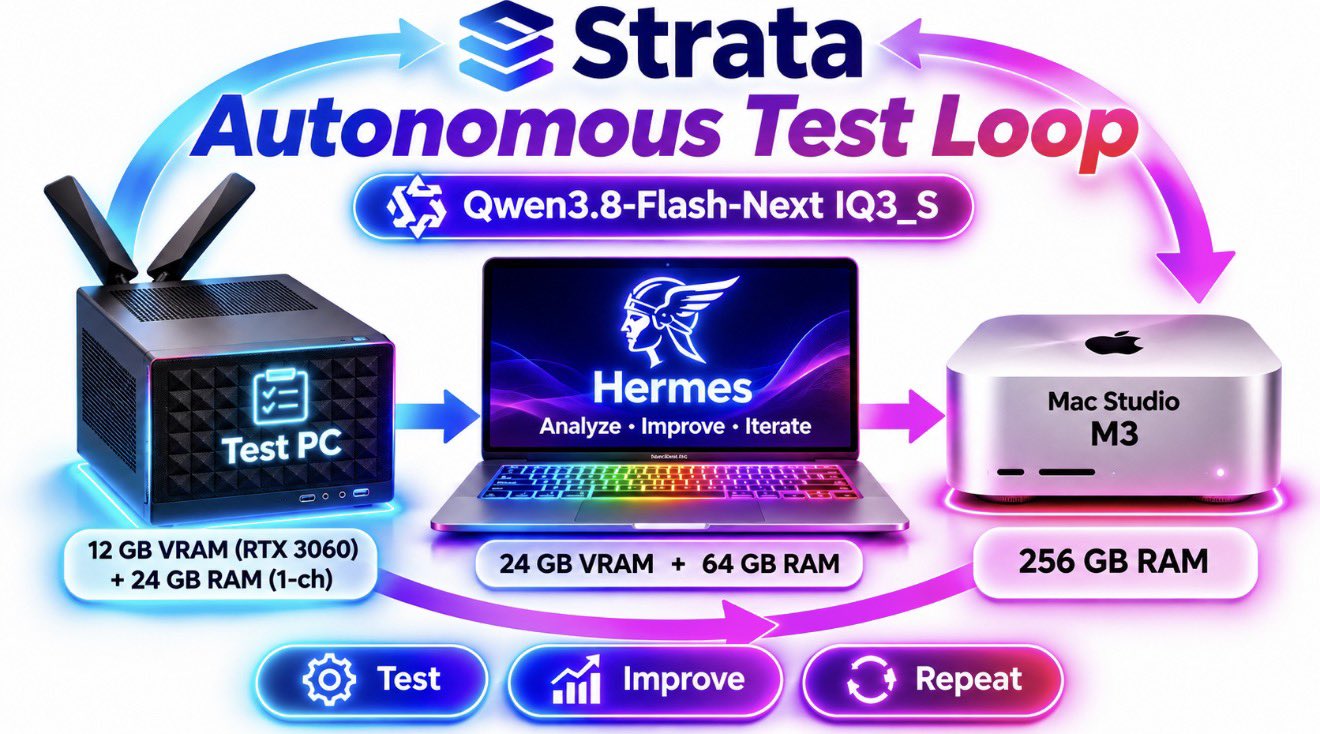
Configurație
- PC pentru experimente: RTX 3060 cu 12 GB VRAM și 24 GB RAM pe un singur canal; memorie extrem de limitată și setări de rulare agresive. Funcționează 24/7.
- Hermes (calculatorul P2005): 24 GB VRAM și 64 GB RAM. Analizează rezultatele, verifică munca, aduce îmbunătățiri.
- Mac Studio M3: 256 GB de memorie unificată; întregul model încape în memorie. Rulări paralele de comparație.
- Aceleași fișiere ale modelului, aceeași versiune a modelului și Strata pe toate sistemele; sarcini identice și repetiții corespunzătoare.
Ce se măsoară
- Utilitatea pe sarcini reale cu hardware limitat.
- Degradarea la ferestre de context mari.
- Calitatea răspunsurilor pe hardware diferit.
- Dacă modelul își poate îmbunătăți singur munca: găsi erori, le corecta și le preveni într-o buclă continuă.
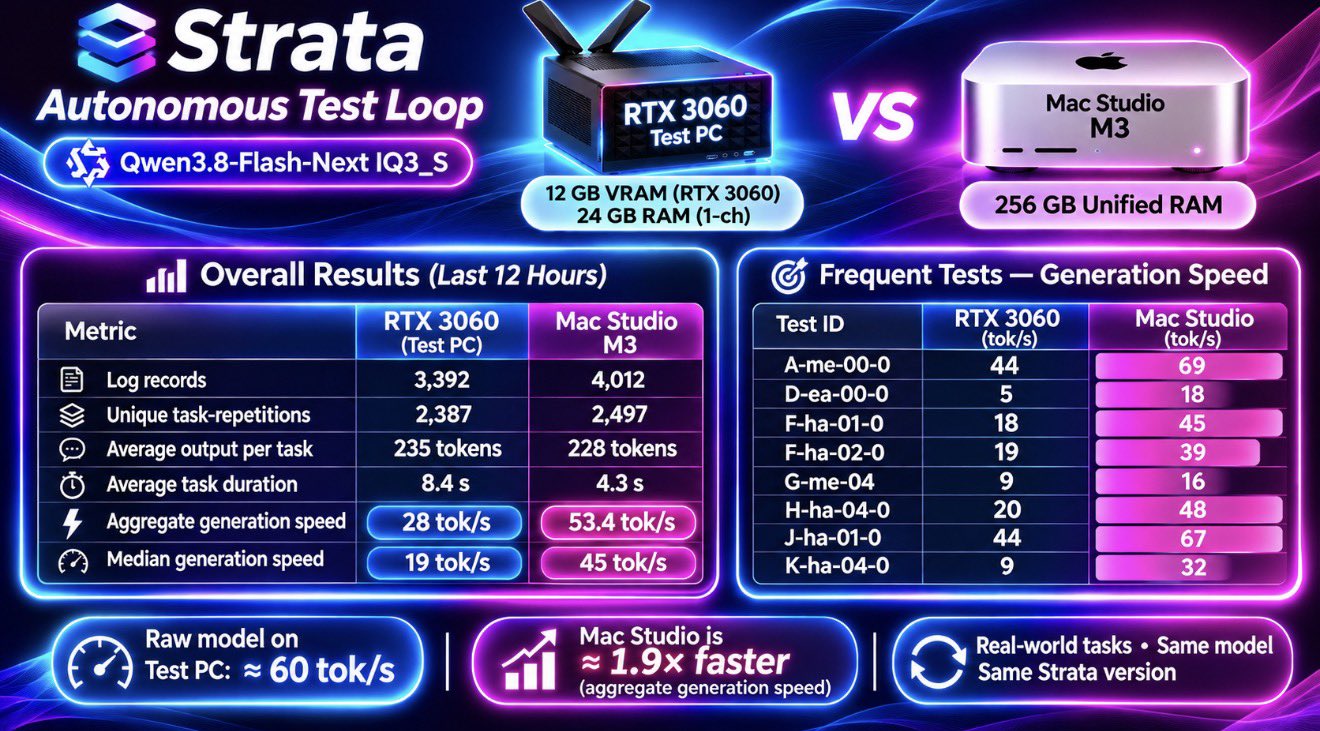
Viteză, ultimele 12 ore
| Indicator | RTX 3060 | Mac Studio M3 |
|---|---|---|
| Înregistrări în log | 3392 | 4012 |
| Repetiții unice ale sarcinilor | 2387 | 2497 |
| Ieșire medie pe sarcină, tokeni | 235 | 228 |
| Durata medie a sarcinii, s | 8.4 | 4.3 |
| Viteză de generare agregată, tok/s | 28 | 53.4 |
| Viteză de generare mediană, tok/s | 19 | 45 |
| ID sarcină | RTX 3060, tok/s | Mac Studio M3, tok/s |
|---|---|---|
| A-me-00-0 | 44 | 69 |
| D-ea-00-0 | 5 | 18 |
| F-ha-01-0 | 18 | 45 |
| F-ha-02-0 | 19 | 39 |
| G-me-04 | 9 | 16 |
| H-ha-04-0 | 20 | 48 |
| J-ha-01-0 | 44 | 67 |
| K-ha-04-0 | 9 | 32 |
Viteza de generare agregată este de aproximativ 1,9 ori mai mare pe Mac Studio. Modelul brut pe PC-ul pentru experimente atinge aproximativ 60 tok/s. Hermes generează mai repede, dar are altă încărcare, așa că o comparație directă ar fi înșelătoare.
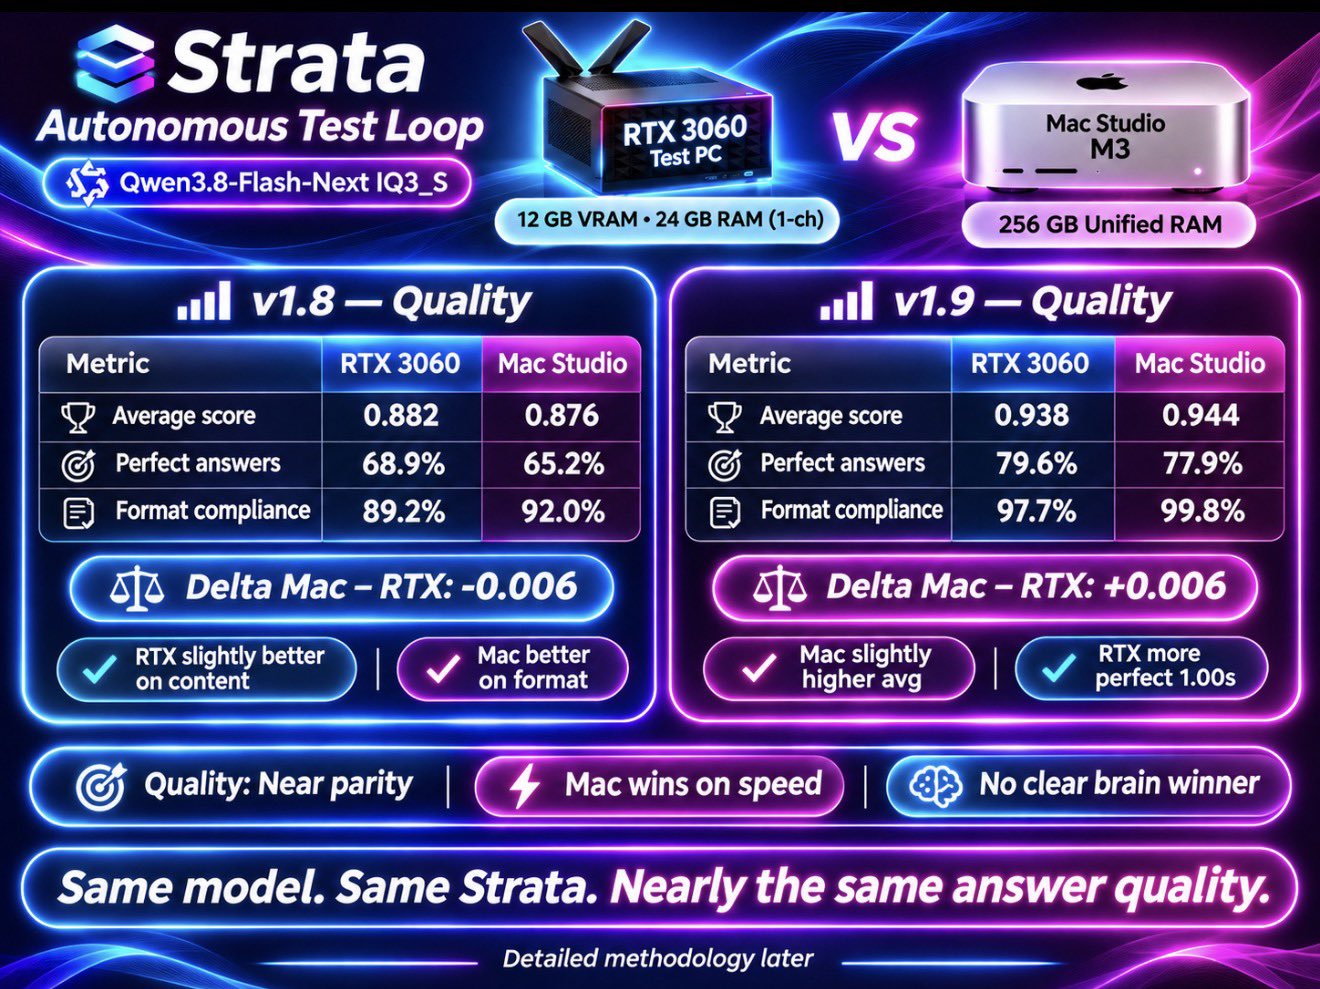
Calitatea răspunsurilor: v1.8 și v1.9
| Indicator | RTX 3060 v1.8 | Mac Studio v1.8 | RTX 3060 v1.9 | Mac Studio v1.9 |
|---|---|---|---|---|
| Scor mediu | 0.882 | 0.876 | 0.938 | 0.944 |
| Răspunsuri perfecte, % | 68.9 | 65.2 | 79.6 | 77.9 |
| Respectarea formatului, % | 89.2 | 92.0 | 97.7 | 99.8 |
| Diferența Mac − RTX | −0.006 | +0.006 | ||
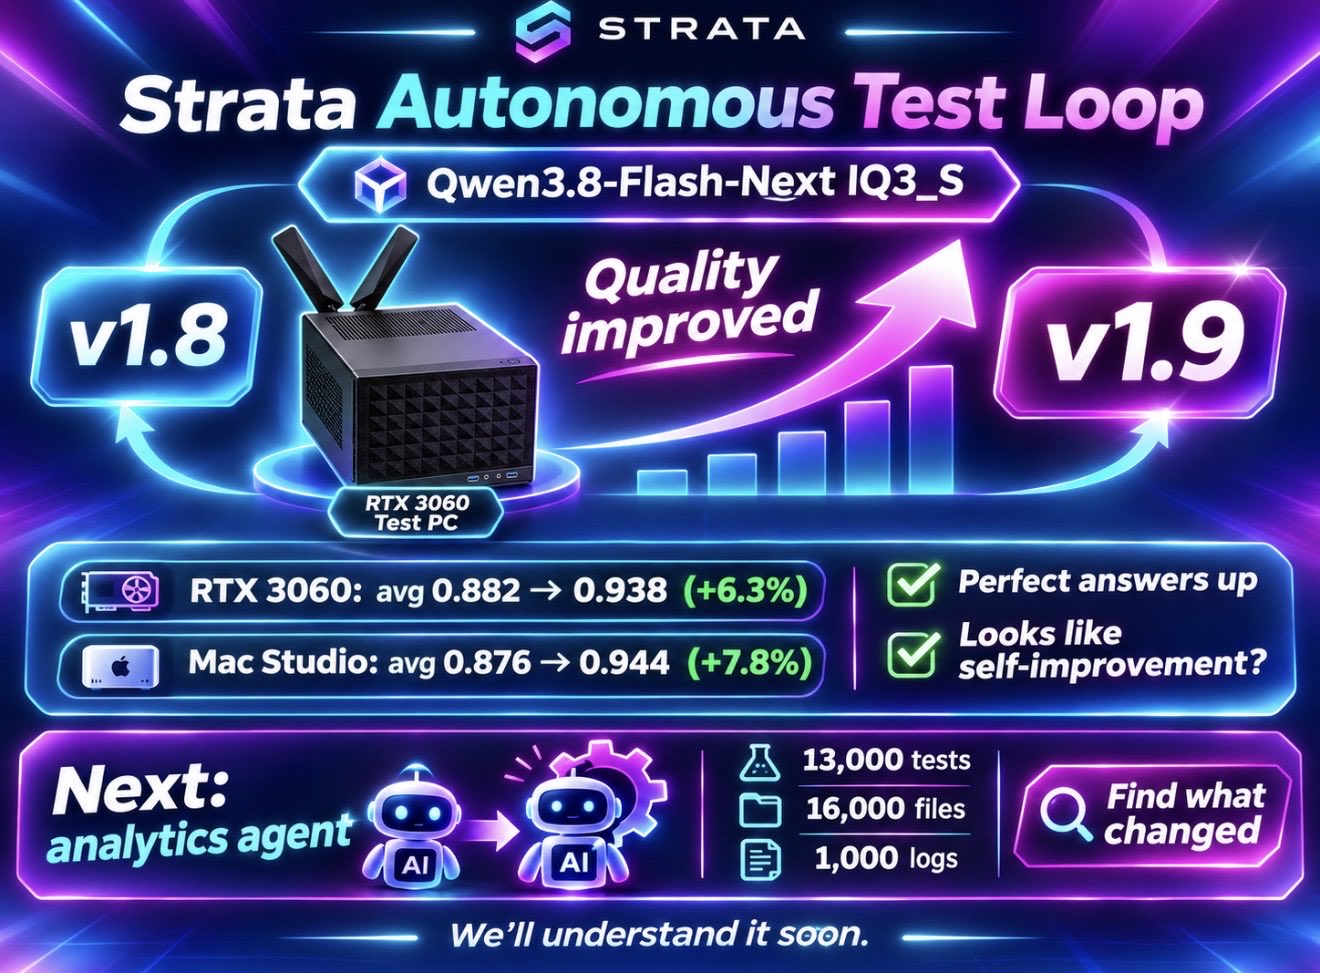
Calitatea este aproape egală; la viteză câștigă Mac-ul. De la v1.8 la v1.9 scorul mediu a crescut cu 6,3% pe RTX 3060 și cu 7,8% pe Mac Studio; a crescut și ponderea răspunsurilor perfecte. Diferențele pe categorii sunt încă analizate.
Comportamentul agentului
Fără indicații în prompturi, agentul a început să estimeze costul în tokeni al îmbunătățirilor sale și, în unele versiuni, să-și optimizeze procesele pentru a reduce consumul inutil de tokeni.
Mai departe
Date colectate: 13.000 de rulări, 16.000 de fișiere, 1.000 de fișiere de log. Se construiește un demo al unui sistem analitic pentru o analiză mai aprofundată a rezultatelor acestui experiment.