
Пять дней автономной разработки локального ИИ: с 77% до 99%
Пять дней экспериментальной самоулучшающейся среды разработки вокруг замороженной локальной модели: качество, скорость, стоимость и открытые вопросы.
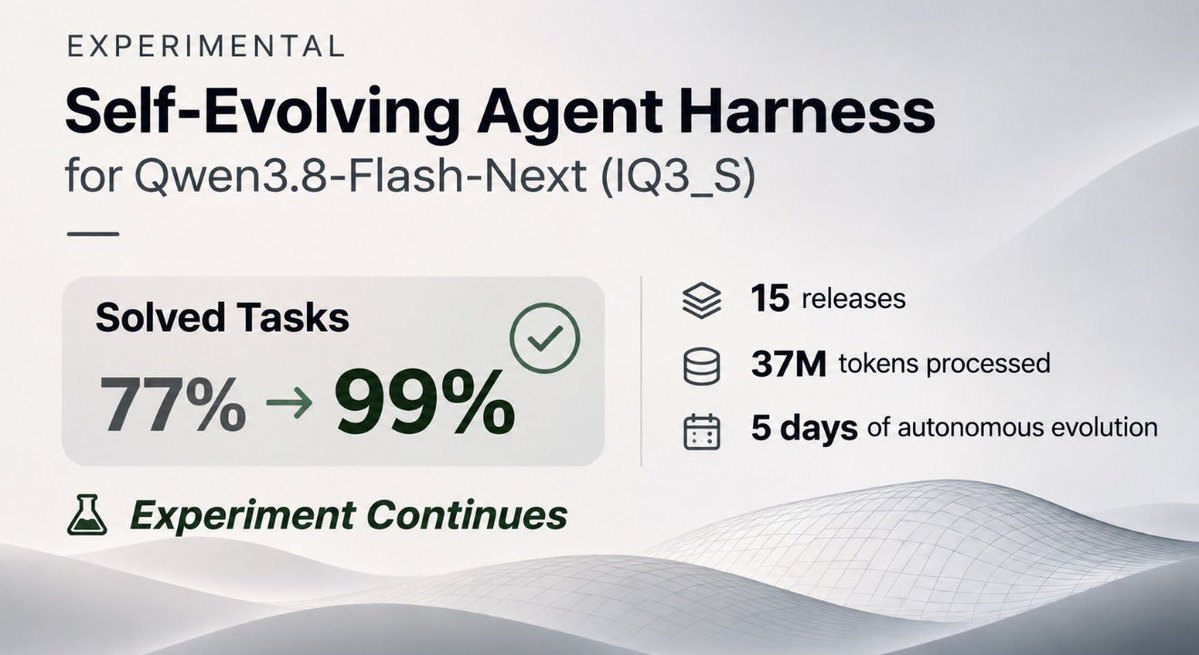
С 31 октября по 5 ноября 2026 экспериментальная среда разработки для Qwen3.8-Flash-Next IQ3_S подняла долю идеально решённых задач с 77% до 99% на фиксированном наборе из 178 задач (счета, таблицы, диагностика, код и фильтрация). Веса модели не дообучались.
Инференс перешёл со Strata на Basalt. Декодирование выросло примерно с 80 до 130–220 ток/с; prefill примерно удвоился; полный прогон бенчмарка сократился с 87 минут до 6,9. Среда разработки прошла 15 релизов с контрактными проверками.
На машинах, занятых бенчмарками, было около 34 000 вызовов модели и около 37 млн обработанных токенов (около 4 млн полезных токенов ответа). Календарное время — 120 часов; большая доля мощности простаивала из‑за смены железа, перезапусков и ожидания решений человека.
Оценка стоимости того же объёма токенов через коммерческие API (33 млн входных и 4 млн выходных, стандартные тарифы, без кэша): Qwen Flash около 3,25 $; DeepSeek Flash 7–15 $; Gemini 2.5 Flash около 20 $; GPT-5.4 Mini около 43 $; Grok 4.3 около 51 $; Claude Sonnet 5.5 около 106 $; GPT-5.4 около 143 $. Локальное электричество за пять дней оценивается в 7–10 € при 0,25 €/кВт·ч, включая простой. Это проверка масштаба, а не утверждение, что локальный ИИ всегда дешевле или что модели равны.
Против базовой линии сырой модели с тем же бюджетом вычислений (слепой best-of-2) среда разработки дала +13,5 процентных пункта. Идут holdout-прогоны, чтобы проверить устойчивость на незнакомых задачах. Релизы, метод и бенчмарки — на GitHub.