
Vijf dagen autonome lokale AI-ontwikkeling: van 77% naar 99%
Vijf dagen van een experimenteel zelfverbeterend ontwikkelomgeving rond een bevroren lokaal model: kwaliteit, snelheid, kosten en open punten.
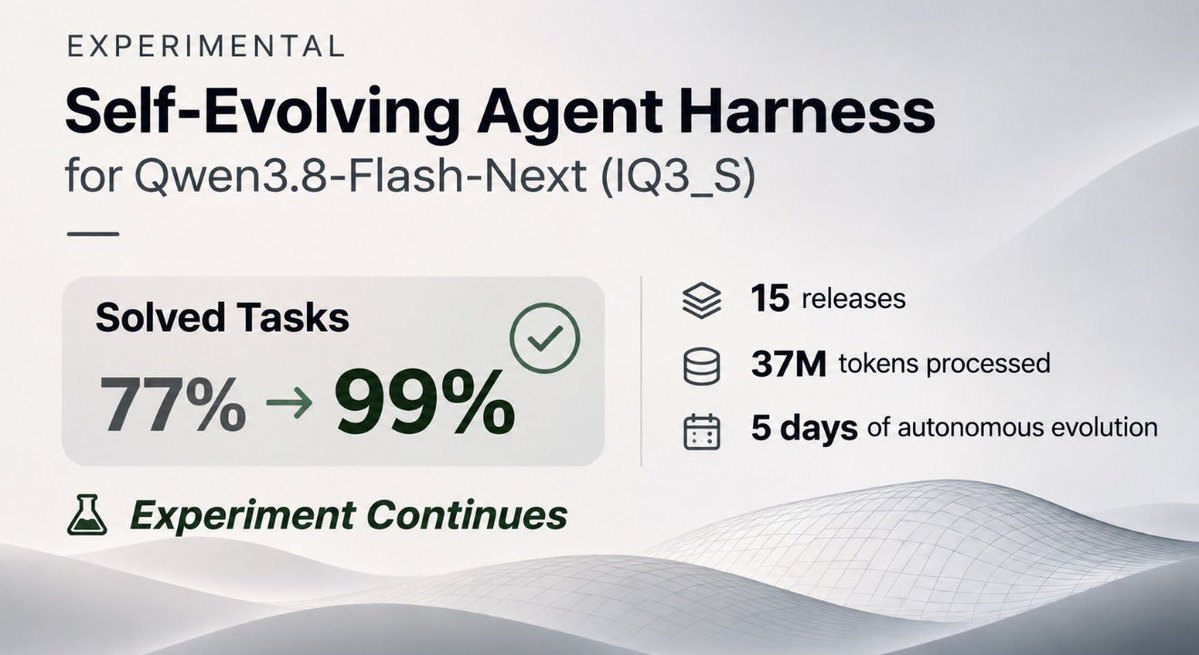
Tussen 31 oktober en 5 november 2026 tilde een experimenteel ontwikkelomgeving voor Qwen3.8-Flash-Next IQ3_S het aandeel perfect opgeloste taken van 77% naar 99% op een vaste set van 178 taken (facturen, spreadsheets, diagnose, code en filters). Modelgewichten werden niet fine-tuned.
Inferentie ging van Strata naar Basalt. Decode steeg van ongeveer 80 naar 130–220 tok/s; prefill ongeveer verdubbeld; een volledige benchmark daalde van 87 minuten naar 6,9. Het ontwikkelomgeving had 15 releases met contractcontroles.
Op de benchmarkmachines: ongeveer 34.000 modelaanroepen en ongeveer 37 miljoen verwerkte tokens (ongeveer 4 miljoen nuttige antwoordtokens). Kalendertijd: 120 uur; een groot deel van de capaciteit bleef ongebruikt door hardwarewisselingen, herstarts en wachten op menselijke beslissingen.
Geschatte kosten van hetzelfde tokenvolume via commerciële API’s (33M input en 4M output, standaardtarieven, zonder cache): Qwen Flash ongeveer $3,25; DeepSeek Flash $7–15; Gemini 2.5 Flash ongeveer $20; GPT-5.4 Mini ongeveer $43; Grok 4.3 ongeveer $51; Claude Sonnet 5.5 ongeveer $106; GPT-5.4 ongeveer $143. Lokale stroom over vijf dagen ongeveer €7–10 bij €0,25/kWh inclusief idle. Dit is een schaalcheck, geen claim dat lokale AI altijd goedkoper is of dat modellen gelijk zijn.
Tegen een ruwe-modelbaseline met gelijk rekenbudget (blinde best-of-2) scoorde het ontwikkelomgeving +13,5 procentpunten. Holdout-runs controleren of winsten standhouden op ongezien werk. Releases, methode en benchmarks staan op GitHub.